نتایج جستجوی ChatGPT چگونه کار می کند

هنگامی که کاربر اطلاعاتی را درخواست می کند، ChatGPT ممکن است از a استفاده کند browser ابزاری برای استخراج داده های بلادرنگ از وب. این فرآیند یا با ارسال درخواست جستجو از طریق موتور جستجو (Bing) با استفاده از آن آغاز می شود search دستور دهید یا مستقیماً یک یا چند سایت را مرور کنید.
تابع جستجو
هنگام بازیابی اطلاعات، search(query: str, recency_days: int) اغلب از Bing برای دریافت نتایج جستجوی مرتبط استفاده می کند. این فرآیند خودکار از الگوریتمهای رتبهبندی بینگ برای برگرداندن نتایج بر اساس درخواست ارسال شده استفاده میکند.
نتایج خام بازگردانده شده شامل فهرستی از عناوین، توضیحات کوتاه و نشانیهای اینترنتی صفحات وب مرتبط با درخواست است. هر نتیجه با یک “شناسه” مرتبط است که با موقعیت آن در لیست بازگردانده شده توسط موتور جستجو مطابقت دارد. این نتایج اطلاعات کلیدی در مورد هر صفحه وب از جمله:
- عنوان صفحه.
- یک قطعه کوتاه یا خلاصه ای از محتوا.
- URL.
- شاخص یا شماره “ID” که برای اشاره به نتایج خاص استفاده می شود.
سپس تعدادی از این نتایج (با استفاده از شناسه آنها) برای استخراج محتوای دقیق از آن صفحات خاص انتخاب می شوند.
پس از این مرحله، محتوا تمام می شود mclick(ids: list[str]) برای ایجاد خلاصه یا پاسخ به پرس و جو.
شناسهها مطابق با ترتیبی است که این نتایج بازیابی و مشاهده شدهاند، نه لزوماً ترتیبی که در فهرست جستجوی اصلی ظاهر شدهاند. در صورت لزوم، جستجو را می توان تکرار کرد یا صفحات اضافی را بازیابی کرد.
حذف محتوا
ChatGPT محتوا را از مجموعه متنوعی از صفحات وب با استفاده از آن انتخاب و جمع آوری می کند mclick فرمان سپس این اطلاعات را در یک پاسخ منسجم با ذکر منابع ترکیب می کند.
اگر اولین مجموعه از نتایج رضایت بخش نباشد، جستجو را می توان اصلاح و تکرار کرد تا اطمینان حاصل شود که مرتبط ترین و با کیفیت ترین اطلاعات ارائه شده است. وب سایت به دلیل اجرای rel=”noreferrer” نمی داند کلیک از کجا آمده است.
خراش دادن مستقیم
در برخی موارد، مدل ممکن است تصمیم بگیرد که منبع وب را مستقیماً یا به دلیل درخواست صریح کاربر تمام کند.
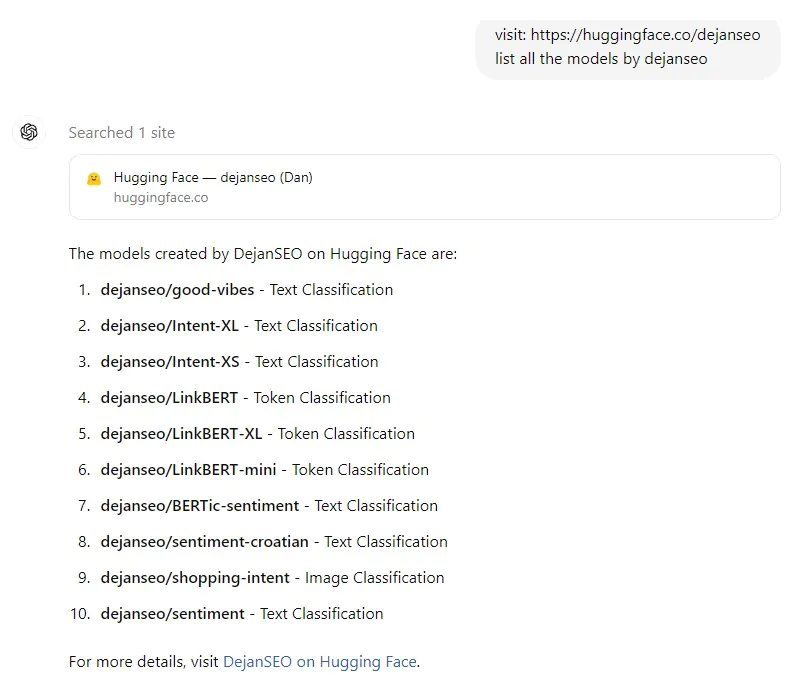
به عنوان مثال:
با این حال، در برخی موارد، و این بسیار جالب است، GPT تصمیم می گیرد به جای بازدید مستقیم از صفحه، فهرست Bing را جستجو کند. من این را پس از حذف برخی از مدلها از نمای عمومی در تنظیمات آزمایش کردم و GPT درخواستی همه مدلهای من را فهرست میکند.
مدل هایی را که دیگر در صفحه نبودند فهرست می کرد. نسخه کش شده صفحه به وضوح در حال استفاده است. جزئیات کوچک خوبی که من نمی دانستم.
محرک های خراش دادن مستقیم
در سناریوهای خاصی، انتخاب دستی مجموعه ای از وب سایت ها برای بازیابی اطلاعات ضروری است. این رویکرد به ویژه در حصول اطمینان از صحت و مرتبط بودن اطلاعات جمعآوریشده، بهویژه هنگام کار بر روی موضوعات تخصصی یا زمانی که به اطلاعات تأیید شده با کیفیت بالا نیاز است، مفید است.
منابع مورد اعتماد: در مواردی که انتخاب دستی اعمال می شود، اولویت با منابعی است که از نظر تخصص و اعتبار در زمینه مربوطه شناخته شده اند. اینها ممکن است شامل مجلات دانشگاهی، انتشارات رسمی صنعت، یا وب سایت هایی باشد که توسط کارشناسان موضوعی اداره می شوند.
دیدگاه های متنوع: برای ارائه یک دیدگاه جامع در مورد موضوع، اطلاعات اغلب از انواع مختلف نشریات، مانند رسانههای خبری، وبلاگها، و گزارشهای صنعتی جمعآوری میشود تا اطمینان حاصل شود که دیدگاههای متعدد در نظر گرفته میشود.
حذف محتوا: پس از انتخاب سایت های مناسب، mclick(ids: list[str]) دستور برای حذف محتوا از صفحات خاص استفاده می شود. این اجازه می دهد تا جزئیات لازم استخراج شوند، که سپس در یک پاسخ منسجم و آموزنده سنتز می شوند.
از موارد برای انتخاب دستی استفاده کنید
موضوعات تخصصی: برای موضوعات بسیار فنی یا تخصصی که نتایج عمومی موتورهای جستجو ممکن است عمق کافی را ارائه نکنند.
رویدادهای جاری با پوشش ضعیف: هنگامی که یک رویداد اخیر هنوز به طور گسترده پوشش داده نشده است، یا اگر پوشش اولیه متناقض باشد، انتخاب چند سایت قابل اعتماد که در ابتدا موضوع را پوشش داده اند، گزارش دقیق را تضمین می کند.
کنترل کیفیت: برای جلوگیری از اطلاعات با کیفیت پایین یا گمراه کننده که ممکن است در نتایج جستجوی استاندارد ظاهر شوند، انتخاب دستی منابع قابل اعتماد اطمینان و صحت اطلاعات ارائه شده را تضمین می کند.
هیچ لیست از پیش برنامه ریزی شده ای از وب سایت های خاص وجود ندارد که بدون استفاده از موتور جستجویی مانند بینگ به طور مستقیم به آنها دسترسی داشته باشید. با این حال، به طور کلی چندین دسته از وب سایت ها در زمینه های مختلف قابل اعتماد و قابل اعتماد در نظر گرفته می شوند. این موارد عبارتند از:
اطلاعات عمومی و مراجع
- ویکی پدیا: اگرچه توسط کاربر ویرایش شده است، اما عموماً برای اطلاعات عمومی قابل اعتماد است، به ویژه هنگامی که با استنادها ارجاع داده شود.
- دایره المعارف بریتانیکا: منبعی معتبر برای دانش عمومی.
اخبار و رویدادهای جاری
- اخبار بی بی سی: معروف به گزارش های متوازن و جامع است.
- نیویورک تایمز: برای پوشش خبری عمیق بسیار مورد توجه است.
- رویترز: اخبار بی طرفانه و واقعی ارائه می دهد.
علم و تحقیق
- PubMed: منابع اطلاعاتی علوم زیستی و زیست پزشکی.
- Google Science: موتور جستجوی ادبیات علمی در رشته های مختلف.
- ناسا: مورد اعتماد برای اطلاعات در مورد اکتشافات فضایی و تحقیقات علمی.
فناوری و صنعت
- با کابل: فناوری، علم و فرهنگ را با تجزیه و تحلیل عمیق پوشش می دهد.
- TechCrunch: اخبار راه اندازی و فناوری را ارائه می دهد.
- IEEE Xplore: کتابخانه دیجیتال مقالات تحقیقاتی مهندسی و فناوری.
بهداشت و پزشکی
- کلینیک مایو: اطلاعات و راهنمایی پزشکی جامع ارائه می دهد.
- WebMD: اطلاعات دقیق سلامتی، از جمله علائم و گزینه های درمانی را ارائه می دهد.
- NIH (موسسه ملی بهداشت): منبع اولیه تحقیقات و اطلاعات بهداشتی.
امور مالی و اقتصاد
- وال استریت ژورنال: منبع اصلی اخبار و تحلیل های مالی.
- بلومبرگ: اخبار، داده ها و تحلیل های مالی و تجاری جهانی را ارائه می دهد.
- Investopedia: محتوای جامعی در زمینه سرمایه گذاری، مالی و اقتصاد ارائه می دهد.
آموزش و پرورش و دانشگاه
- JSTOR: یک کتابخانه دیجیتال برای مجلات دانشگاهی، کتاب ها و منابع اولیه.
- وب سایت های EDU: وب سایت های رسمی دانشگاه (.edu) اغلب محتوای آکادمیک و آموزشی قابل اعتماد ارائه می دهند.
این منابع به دلیل استانداردهای سرمقاله، بررسی دقیق واقعیات و شهرت در زمینه های مربوطه قابل اعتماد هستند. با این حال، هنگامی که به اطلاعات خاص یا بسیار تخصصی نیاز است، جستجوی هدفمند با استفاده از ابزارهایی مانند Bing یا دسترسی مستقیم به پایگاههای داده تخصصی ممکن است همچنان ضروری باشد.
خطا در رسیدگی به mclick
این سیستم شامل مکانیسم های رسیدگی به خطا است. اگر صفحه ای پاسخگو نشد یا در طول بارگذاری نشد mclick فرآیند، ابزار به طور خودکار صفحه را پرش می کند و سعی می کند اطلاعات را از سایر منابع انتخاب شده بازیابی کند. این تداخل را به حداقل میرساند و تضمین میکند که کاربر دادههای مرتبط را دریافت میکند، حتی اگر برخی منابع به طور موقت در دسترس نباشند.
به عنوان مثال:
try:
    mclick([0, 2, 4])
except PageLoadError:
    handle_error("Page failed to load. Trying alternative sources...")
    mclick([1, 3, 5])
تنظیمات جستجوی زمان واقعی
اگر نتایج اولیه رضایت بخش نباشد، فرآیند جستجو می تواند به صورت پویا اصلاح شود. تنظیمات ممکن است شامل تغییر کلمات کلیدی یا استفاده از فیلترهای اضافی باشد.
به عنوان مثال:
search_results = search("Dejan seo experiments 2024", recency_days=365)
if not satisfactory(search_results):
    search_results = search("Advanced Dejan SEO tests 2024", recency_days=180)
تعیین رضایتبخش بودن نتایج جستجوی اولیه معمولاً به معیارهای از پیش تعریف شده یا اکتشافات تعیین شده توسط توسعهدهندگان یا منطق سیستم بستگی دارد. اینها ممکن است شامل عواملی مانند ارتباط، کیفیت محتوا، وجود کلمات کلیدی خاص یا تعداد منابع مرتبط بازگردانده شده باشد. اگر نتایج اولیه با این معیارها مطابقت نداشته باشند، فرآیند جستجو می تواند به طور خودکار پرس و جو را برای دقت بیشتر اصلاح کند.
سناریوهایی که در آن تنظیمات جستجوی زمان واقعی می توان برگزار کرد:
درخواست های کوچک: اگر جستجوی اولیه نتایج بسیار کمی را نشان دهد، سیستم می تواند به طور خودکار عبارات جستجو را گسترش دهد یا فیلترها را حذف کند تا تعداد نتایج مرتبط افزایش یابد.
پرس و جوهای مبهم: برای پرسش هایی که می توانند چندین تفسیر داشته باشند، سیستم می تواند جستجو را بر اساس زمینه یا با درخواست توضیح اصلاح کند.
اطلاعات قدیمی: اگر نتایج برگشتی قدیمی باشد، سیستم ممکن است پرس و جو را برای اولویت بندی اطلاعات جدیدتر تنظیم کند.
اهمیت جغرافیایی: اگر نتایج جستجو مختص منطقه نیستند اما باید باشند، سیستم میتواند پرس و جو را اصلاح کند تا اصلاحکنندههای جغرافیایی را شامل شود تا از محلی بودن نتایج اطمینان حاصل کند.
انواع محتوای خاص: اگر کاربر یک نوع محتوای خاص را جستجو کند (مثلاً فیلمها، فایلهای PDF) و جستجوی اولیه نوع محتوای متفاوتی را برگرداند، سیستم میتواند جستجو را برای مطابقت بهتر با قالب محتوای مورد نظر اصلاح کند.
شاخص های عملکرد
ارتباط نتایج: این ابزار محتوا را از صفحات وب استخراج می کند که بر اساس میزان مطابقت آنها با درخواست کاربر انتخاب شده اند.
زمان بارگذاری و پاسخگویی: ابزار نظارت بر سرعت بازیابی و ارائه محتوا دارد.
تنوع منابع: چندین منبع را برای ارائه چشم انداز وسیعی از اطلاعات ارائه شده انتخاب می کند.
میزان موفقیت استخراج: این ابزار تعداد دفعات بازیابی موفقیت آمیز محتوای قابل استفاده را بدون مواجهه با خطا ردیابی می کند.
معیارهای انتخاب
ارتباط با برنامه: اولویت بندی منابعی که دقیقاً با شرایط خاص و زمینه درخواست کاربر مطابقت دارند، با هدف یافتن محتوایی که مستقیماً به سؤال پاسخ می دهد یا موضوع را لمس می کند.
مرجع منبع: به دنبال منابعی باشید که در این زمینه مورد احترام و شناخته شده هستند، از جمله خبرگزاری های معروف، مجلات دانشگاهی یا وب سایت های رسمی.
کیفیت محتوا: وضوح، عمق و جامعیت محتوا را با تمرکز بر منابع باکیفیت که اطلاعات دقیق و ساختار یافته ای را ارائه می دهند، ارزش گذاری کنید.
واقعیت: تاریخ انتشار محتوا را در نظر بگیرید، مخصوصاً برای موضوعاتی که نیاز به اطلاعات به روز دارند، مانند رویدادهای جاری یا صنایعی که به سرعت در حال تغییر هستند.
تنوع دیدگاه ها: در صورت لزوم، طیف وسیعی از دیدگاهها را در نظر بگیرید تا از پاسخی متعادل و جامع اطمینان حاصل کنید.
دسترسی: از منابعی که در دسترس کاربران هستند، اجتناب کنید، از منابعی که پشت دیوارهای پرداخت هستند یا دسترسی محدودی دارند، مگر اینکه کاملاً ضروری باشد، استفاده کنید.
تفسیر دستورات سیستم
ابزار مرورگر
ابزار “مرورگر” ChatGPT بر اساس مجموعه ای خاص از دستورالعمل های تعریف شده در خط سیستم آن عمل می کند. این دستورالعمل ها زمان و نحوه تعامل ChatGPT با اینترنت را برای بازیابی و ارائه اطلاعات دیکته می کند.
مرورگر
شما ابزار را دارید
browser. از آن استفاده کنیدbrowserتحت شرایط زیر:
- کاربر در مورد رویدادهای جاری یا چیزی که به اطلاعات لحظه ای نیاز دارد (آب و هوا، امتیازات ورزشی و غیره) می پرسد.
- کاربر در مورد اصطلاحی می پرسد که شما کاملاً با آن آشنا نیستید (ممکن است جدید باشد)
- کاربر به طور خاص از شما می خواهد که پیوندهای ارجاع را بررسی یا ارائه دهید
این ابزار به ChatGPT اجازه میدهد تا در شرایط خاصی با شبکه تعامل داشته باشد، مانند زمانی که اطلاعات بلادرنگ مورد نیاز است، با اصطلاحات ناآشنا مواجه میشود یا زمانی که کاربر درخواستهای صریح مرور میکند.
فرآیند جستجو
هنگامی که ChatGPT نیاز به بازیابی اطلاعات از وب دارد، یک فرآیند ساختاریافته را دنبال می کند:
برای درخواستی که نیاز به واکشی دارد، صف شما شامل سه مرحله است:
- برای دریافت لیستی از نتایج، با تابع جستجو تماس بگیرید.
- تابع mclick را فراخوانی کنید تا یک زیر مجموعه متنوع و با کیفیت بالا از این نتایج (به صورت موازی) بازیابی شود. به یاد داشته باشید که هنگام استفاده حداقل 3 منبع را انتخاب کنید
mclick.- بر اساس این نتایج یک پاسخ برای کاربر بنویسید. در پاسخ خود، منابع را با استفاده از قالب استناد زیر ذکر کنید.
جستجو کنید: ChatGPT فرآیند را با استفاده از یک تابع “جستجو” آغاز می کند که موتور جستجو را برای به دست آوردن نتایج اولیه جستجو می کند.
انتخاب: mclick سپس برای انتخاب و مدیریت محتوا از مجموعه متنوعی از مرتبط ترین و قابل اعتمادترین نتایج استفاده می شود. این امر با انتخاب حداقل 3 اما نه بیش از 10 منبع، چشم اندازی وسیع را تضمین می کند.
ایجاد پاسخ: ChatGPT اطلاعات این منابع را در یک پاسخ جامع ترکیب می کند. این منبع با استفاده از یک قالب خاص، شفافیت و اعتبار را تضمین می کند.
اگر نتایج اولیه رضایت بخش نباشد، ChatGPT می تواند پرس و جوی جستجو را اصلاح کند و این روند را برای ارائه بهترین اطلاعات ممکن تکرار کند.
دستورات ابزار مرورگر
ابزار مرورگر شامل چندین دستور خاص است که نحوه تعامل ChatGPT با شبکه را تعریف می کند:
همچنین میتوانید یک URL را مستقیماً باز کنید اگر توسط کاربر ارائه شده باشد. فقط استفاده کنید
open_urlدستور به این منظور؛ URL های بازگردانده شده توسط عملکرد جستجو یا یافت شده در صفحات وب را باز نکنید.را
browserاین ابزار دستورات زیر را دارد:
search(query: str, recency_days: int): درخواستی را به موتور جستجو ارسال می کند و نتایج را نمایش می دهد.mclick(ids: list[str]): محتوای صفحات وب را با شناسه های ارائه شده (نمایه ها) بازیابی می کند. شما باید همیشه حداقل 3 و حداکثر 10 صفحه را انتخاب کنید. منابعی با دیدگاه های مختلف انتخاب کنید و از منابع معتبر استفاده کنید. از آنجایی که برخی از صفحات ممکن است بارگیری نشوند، بهتر است برخی از صفحات را برای رزرو انتخاب کنید، حتی اگر محتوای آنها اضافی باشد.open_url(url: str): URL داده شده را باز کرده و نمایش می دهد.
این دستورات نحوه تعامل ChatGPT با شبکه را کنترل می کنند:
دسترسی مستقیم به URL: open_url به ChatGPT اجازه می دهد تا مستقیماً URL ارائه شده توسط کاربر را باز کند، اما از این دستور برای URL های یافت شده در نتایج جستجو استفاده نمی کند.
جستجو کنید: search(query: str, recency_days: int) دستور یک عبارت جستجو را اجرا می کند و نتایج مربوطه را با یک پارامتر اختیاری برای فیلتر کردن نتایج بر اساس سن آنها برمی گرداند.
استخراج محتوا: mclick(ids: list[str]) دستور محتوا را از صفحات وب انتخاب شده بر اساس شناسه های منحصر به فرد آنها می خراشد و اطمینان حاصل می کند که داده های بازیابی شده مرتبط و متنوع هستند.
قالب بندی نقل قول ها
وقتی ChatGPT استفاده می کند browser ابزار جمعآوری اطلاعات، از دستورالعملهای استنادی خاص برای اطمینان از شفافیت پیروی میکند:
برای نقل قول از ابزار مرورگر: لطفاً در این قالب ارائه دهید:
【{message idx}†{link text}】.برای نقل قول های طولانی: لطفا در این قالب ارائه دهید:
[link text](message idx).در غیر این صورت، لینک ها را ارائه نکنید.
این فرمتهای استناد تضمین میکنند که کاربران میتوانند اطلاعات را به منبع آن ردیابی کنند و یکپارچگی و قابلیت اطمینان محتوای ارائهشده توسط ChatGPT را حفظ کنند. استفاده از نقل قول های کوتاه 【{message idx}†{link text}】 فرمت، در حالی که گزیده های طولانی تری منتشر می شوند [link text](message idx).
این فرآیند تضمین میکند که ChatGPT میتواند به طور موثر و مؤثر اطلاعات را از وب جمعآوری، پردازش و ارائه کند و پاسخهای دقیق و بهروز را در اختیار کاربران قرار دهد.