دیوار نامرئی بین وب سایت شما و دید هوش مصنوعی

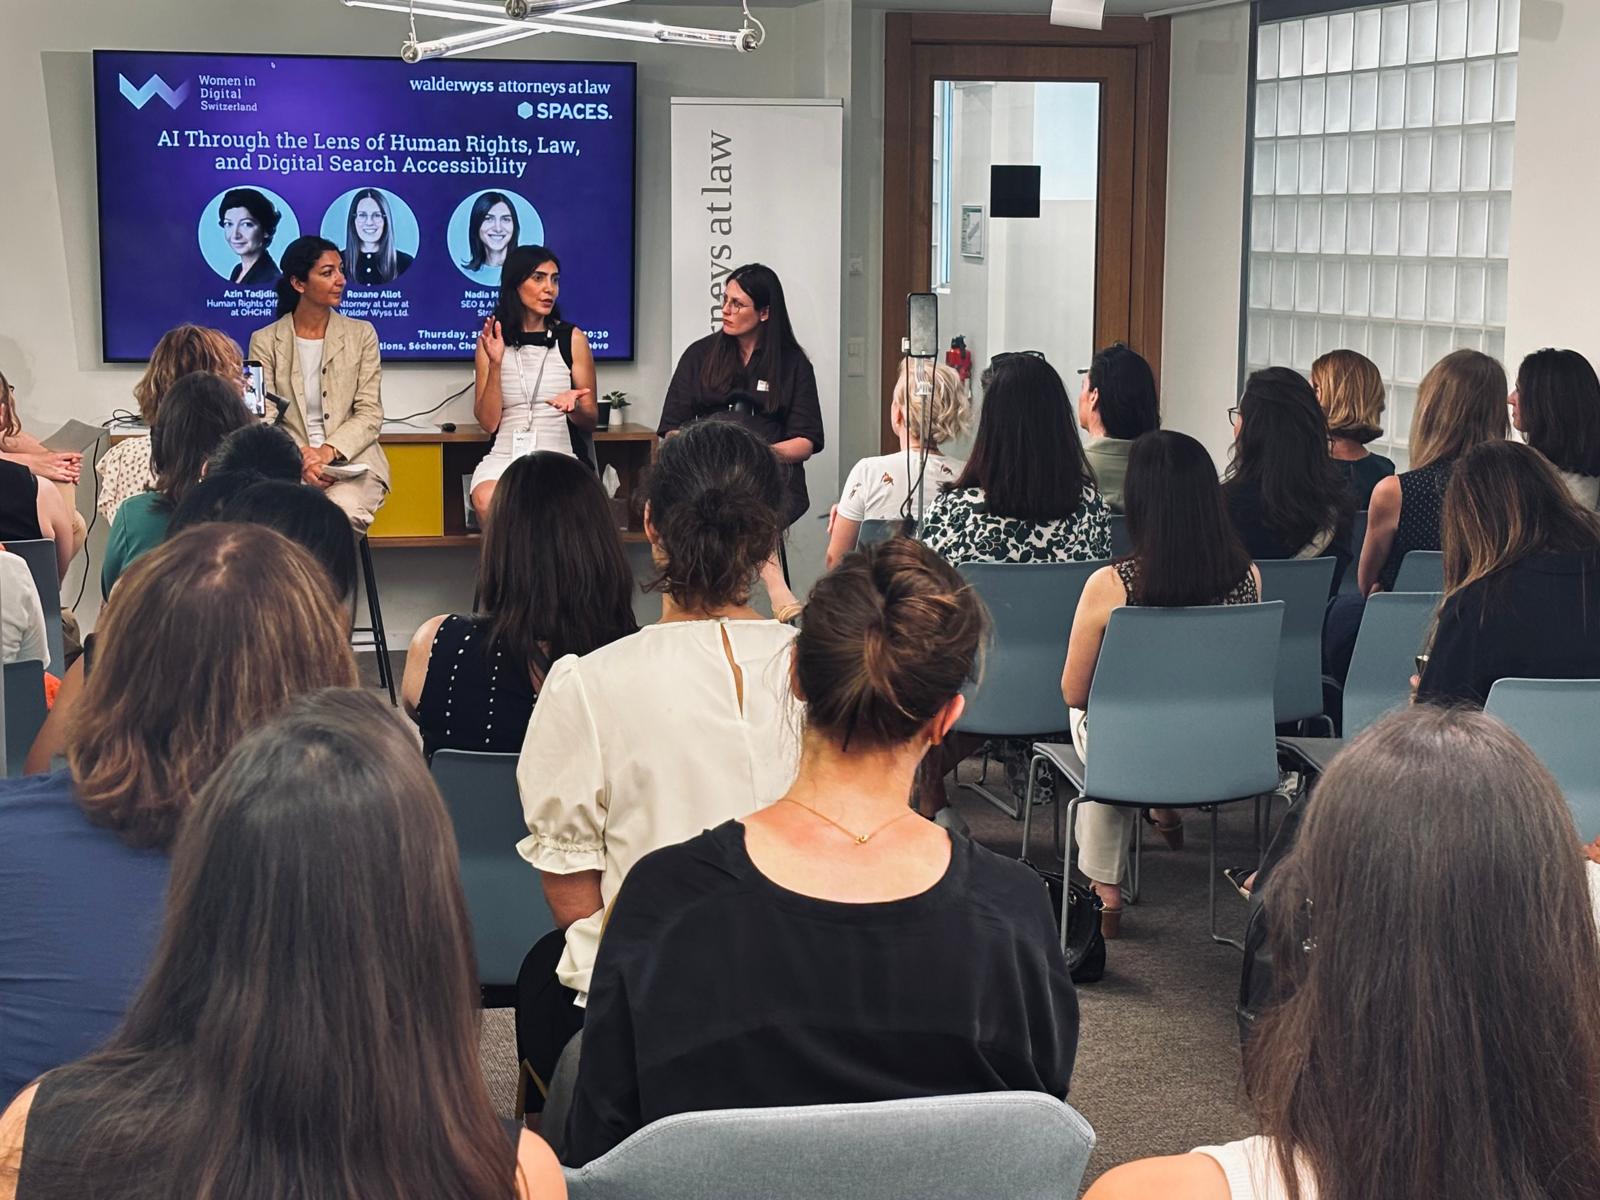
به عنوان بخشی از رویداد اخیر Women in Digital Switzerland که در Spaces Nations در ژنو میزبانی شد، نادیا موهاد، بنیانگذار seo Transformer و SEO & AI Strategist Visibility، به گروهی از کارشناسان پیوست تا چگونگی تغییر هوش مصنوعی حقوق بشر، مقررات و قابلیت کشف دیجیتال را بررسی کند.
نادیا به همراه آذین تاجدینی، افسر حقوق بشر در دفتر کمیساریای عالی حقوق بشر سازمان ملل (OHCHR) و روکسان آلوت، وکیل در Walder Wyss، بینش هایی را در مورد اینکه چگونه جستجوی مبتنی بر هوش مصنوعی نحوه نمایش اطلاعات آنلاین را تغییر می دهد و سازمان ها چه کاری می توانند انجام دهند تا اطمینان حاصل کنند که محتوای آنها در یک محیط دیجیتال قابل مشاهده و قابل دسترس باقی می ماند به اشتراک گذاشت.
یکی از موضوعات کلیدی که از بحث بیرون آمد این بود که قابلیت کشف دیگر فقط یک موضوع فناوری یا بازاریابی دیجیتال نیست. همانطور که سیستم های هوش مصنوعی به دروازه ای برای اطلاعات تبدیل می شوند، دید به طور فزاینده ای بر صدای افرادی که شنیده، باور و بازنمایی می شوند تأثیر می گذارد. در زیر خلاصه ای از بینش های کلیدی به اشتراک گذاشته شده در طول بحث آورده شده است.
شکاف قابل کشف در عصر هوش مصنوعی
در طول بحث میزگرد، نادیا به یکی از مهمترین چالشهایی که امروزه برندها با آن مواجه هستند، یعنی تغییر مکانیک کشفپذیری، پرداخت.
برای سه دهه، معماری اصلی اینترنت منحصراً برای مصرف انسان طراحی شده بود. ما رابط طراحی کردیم، کپی نوشتیم و جریان های کاربر را برای تعامل با انسان ها ترسیم کردیم، نه هوش مصنوعی. این رویکرد انسان محور تا به امروز در خدمت اقتصاد دیجیتال است.
که تا الان مشکلی نبود. عوامل هوش مصنوعی به سرعت به لایه غالبی تبدیل می شوند که از طریق آن مردم به اطلاعات آنلاین دسترسی پیدا می کنند. آنها فقط به سوالات پاسخ نمی دهند. آنها وظایف را انجام می دهند، توصیه هایی ارائه می کنند و از طرف ما اقدام می کنند. آنها، به تمام معنا، رسما شروع به مشارکت در زندگی عمومی ما کرده اند. و آنها این کار را با پاک کردن، تفسیر و بازسازی وب به صورتی که در حال حاضر وجود دارد انجام می دهند – وب که هرگز برای آنها طراحی نشده است.
این یک قطع ارتباط عمیق و تا حد زیادی ناشناخته ایجاد می کند. دنیای واقعی مملو از صداهای تایید شده، موسسات مورد اعتماد، دهه ها تجربه تجاری و سازمان های حقوق بشری است که به سختی به دست آورده اند. اما هوش مصنوعی اعتبارنامه ها را نمی بیند. آن طور که مردم شهرت را تشخیص نمی دهند، آنها کد را می خوانند.
صداهای تأیید شده، سازمانهایی که دههها اعتبار، تخصص قانونی یا اعتماد نهادی دارند، به خوبی کد هوش مصنوعی آنها نخواهند بود. و بیشتر وب به شکل امروزی، دیواری از متن مبهم انسانی است – پف کرده، ساختار ضعیف و ناخوانا برای ماشین هایی که به طور فزاینده ای تصمیم می گیرند چه کسی کشف شود.
چگونه موتورهای جستجو و عوامل هوش مصنوعی وب سایت شما را می خوانند
هر دو از وب سایت شما بازدید می کنند. کاری که وقتی به آنجا میرسند نمیتواند متفاوت از این باشد.
موتورهای جستجوی سنتی چگونه کار می کنند
جستجوی گوگل در سه مرحله مختلف کار می کند.
- اول، خزیدن – برنامه های خودکار به نام خزنده های وب به طور مداوم وب را برای یافتن متن، تصاویر و ویدیو از صفحات اسکن می کنند. خزنده ها را به عنوان کارکنان پستی در نظر بگیرید که دائماً در هر خیابان در اینترنت پرسه می زنند و متوجه می شوند که کدام ساختمان وجود دارد و چه چیزی روی درهای آنها نوشته شده است. اگرچه هیچ رجیستری مرکزی اجباری و واحدی برای همه صفحات وب وجود ندارد، گوگل به شدت به نقشه های سایت XML ارسال شده (فایل ناوبری موتور جستجو) متکی است و پیوندهای صفحات شناخته شده را برای کشف URL های جدید دنبال می کند.
- دوم، نمایه سازی – پس از خزیدن صفحه، یک موتور جستجو مانند گوگل یا بینگ محتوای آن را تجزیه و تحلیل می کند و اطلاعات را در یک پایگاه داده بزرگ ذخیره می کند. به این فکر کنید که یک کارمند پست به اداره باز می گردد و گزارش مفصلی از هر ساختمانی که بازدید می کند ارائه می کند – شامل چه چیزی بود، به چه زبانی صحبت می کرد، برای چه کسی بود. در این مرحله، گوگل همچنین تعیین میکند که آیا یک صفحه نسخه نهایی محتوای آن است یا تکراری از چیزی که قبلاً در جای دیگری وجود دارد.
- سوم، نتایج خدمت — هنگامی که کاربر جستجو میکند، Google فهرست خود را جستجو میکند و صفحاتی را که بهعنوان مرتبطترین و با کیفیتترین صفحات تعیین میکند، برمیگرداند که براساس صدها عامل از جمله مکان، زبان و دستگاه رتبهبندی شدهاند.
- به طور بحرانی، هر صفحه از هر سه مرحله عبور نمی کند. یک صفحه می تواند خزیده شود اما ایندکس نمی شود. می توان آن را ایندکس کرد اما هرگز در نتایج نشان داده نمی شود. معماری ضعیف سایت، محتوای با کیفیت پایین و خطاهای فنی می تواند پیشرفت یک صفحه را متوقف کند – بی سر و صدا و بدون اطلاع صاحب سایت.
چگونه عوامل هوش مصنوعی وب سایت شما را می خوانند
عوامل هوش مصنوعی از طریق سه لنز اصلی به سایت شما دسترسی دارند:
- HTML خام: HTML کد اصلی است که به مرورگر می گوید چه چیزی را نمایش دهد و چگونه آن را سازماندهی کند. به آن به عنوان یک پلان معماری یک ساختمان فکر کنید – نه اینکه ساختمان چگونه نقاشی شده و مبله به نظر می رسد، بلکه اسکلت ساختاری زیر آن است. نماینده مستقیماً این طرح را می خواند و نحوه تودرتو شدن عناصر، سلسله مراتب منطقی صفحه و داده های خامی را که ستون فقرات اطلاعات سایت را تشکیل می دهد، تجزیه و تحلیل می کند. این به نماینده اجازه می دهد تا روابط بین اقلام را درک کند – اگر دکمه خرید اکنون در داخل ظرف محصول باشد، نماینده استنباط می کند که این دکمه متعلق به آن محصول خاص است.
- اسکرین شات ها: عامل یک عکس فوری از صفحه رندر شده می گیرد و از یک مدل بصری برای تفسیر بصری آن استفاده می کند، روشی که یک فرد بینا می تواند به یک صفحه نگاه کند و بلافاصله طرح آن را درک کند. می تواند تشخیص دهد که نوار جستجو در گوشه سمت راست بالا یک ابزار ناوبری است، یا اینکه یک دکمه قرمز بزرگ حذف وزن بیشتری نسبت به یک لینک کمک کوچک دارد. نشانه های بصری مانند رنگ، اندازه و مجاورت معنی دارند. با این حال، تجزیه و تحلیل اسکرین شات آهسته و منابع فشرده است، و زمانی که ساختار صفحه واضح است، آن را به یک روش جایگزین تبدیل می کند تا یک روش اولیه.
- درخت دسترسی: این یک خلاصه ساده و ساختاریافته از یک صفحه وب است که به طور خودکار توسط مرورگر ایجاد میشود و در اصل برای کمک به صفحهخوانها برای کمک به کاربران کمبینا طراحی شده است. برای یک عامل هوش مصنوعی، مانند یک پلان طبقه تمیز از یک ساختمان عمل می کند، تمام دکوراسیون را از بین می برد و فقط درها، سوئیچ ها و عناصر اصلی را نشان می دهد – هر عنصر تعاملی در صفحه با آنچه انجام می دهد توصیف می شود، نه آنچه به نظر می رسد. به نماینده می گوید: این یک منوی ناوبری است، این یک قسمت جستجو است، این یک دکمه ارسال است.
یک سیگنال واحد هرگز برای کشف هوش مصنوعی کافی نیست
تکیه بر هر یک از این ورودی ها باعث ایجاد شکاف می شود. فقط در کد خام، یک عامل میتواند با عنصری بدون برچسب واضح مواجه شود – چیزی که از نظر بصری طوری طراحی شده است که مانند یک دکمه به نظر برسد و رفتار کند، اما نشانگر ساختاری برای شناسایی آن ندارد. یک اسکرین شات ممکن است نشان دهد که آن دکمه در کجای صفحه قرار دارد، اما به عامل نمیگوید چه چیزی را راهاندازی میکند. درخت دسترسپذیری هدف کاربردی را ارائه میکند، اما فاقد زمینهبندی طرحبندی است که به عامل در درک گروهبندی و سلسلهمراتب بصری کمک میکند.
بنابراین، عوامل مدرن هر سه را ترکیب می کنند. آنها از کد و درخت دسترسپذیری برای ایجاد فهرستی ساختاریافته از عناصر تعاملی استفاده میکنند، سپس آن را با یک نمایش بصری برای درک طرحبندی و گروهبندی ارجاع میدهند. نتیجه یک تصویر ترکیبی از صفحه شما است – که از چندین سیگنال به طور همزمان ترکیب شده است، روشی که شخص ممکن است نقشه را بخواند، به تابلوهای خیابان نگاه کند، و به یکباره به نقاط دیدنی نگاه کند تا در یک شهر جدید حرکت کند.
این چه معنایی برای وب سایت شما دارد
هوش مصنوعی مولد مانند جستجوی سنتی کار نمی کند. حجم عظیمی از دادهها را هضم میکند، آنها را تجزیه میکند و یک پاسخ کاملاً جدید را بر اساس مدلهای آماری بازسازی میکند. وقتی منبعی فاقد زیرساخت فنی برای شناسایی باشد – بدون دادههای ساختاریافته، بدون برچسبگذاری شی، بدون حضور در نمودار دانش – موتورهای هوش مصنوعی به آن استناد نمیکنند. آن را جذب می کنند. ایده اصلی در پاسخ هوش مصنوعی بازسازی شده است، اما نویسنده صفر انتساب، ترافیک صفر و دید صفر دریافت می کند. دانش استخراج می شود. صدای انسان پاک می شود
مفهوم عملی آن ساده است: وب سایت شما باید سیگنال های واضح، ثابت و بدون ابهام را در تمام کانال ها ارسال کند. صفحهای که برای انسان زیبا به نظر میرسد، اما بر روی کدهای بدون ساختار ساخته شده است، نقشهای معنایی درستی ندارد، و محتوای کلیدی را به گونهای بار میکند که ماشینها قادر به پردازش آن نیستند، از دیدگاه عامل تا حد زیادی غیرقابل خواندن است. اینطور نیست که نماینده سایت شما را دوست نداشته باشد. این است که نماینده نمی تواند آن را بخواند.
موتورهای جستجوی سنتی و عوامل هوش مصنوعی به همان کیفیت اولیه پاداش میدهند: سایتی که از نظر فنی تمیز، ساختار معنایی و با در نظر گرفتن تفسیر ماشینی ساخته شده است. بدون آن، موتور جستجو به سادگی شما را در رتبه بالاتری قرار نمی دهد. یک عامل هوش مصنوعی شما را نمییابد، نمیفهمد یا به شما اعتماد نمیکند – و به منبعی میرود که بتواند.
باریک بودن پنجره دید هوش مصنوعی
درک چگونگی خواندن سایت شما توسط نمایندگان تنها نیمی از تصویر است. نیمی دیگر متوجه می شوند که اصلا فضای کمی برای دیدن وجود دارد.
موتورهای هوش مصنوعی با یک رژیم سخت داده کار می کنند. مانند محققی فکر کنید که یک ساعت فرصت دارد تا مختصری درباره یک موضوع پیچیده بنویسد – آنها ابتدا به واضح ترین و سازمان یافته ترین منابع می روند و هر چیزی را که رمزگشایی آن بیش از حد طولانی طول می کشد نادیده می گیرد. هنگام تولید یک پاسخ، سیستمهای هوش مصنوعی از مجموعه محدودی از محتوا در سراسر وب استفاده میکنند و با محدودیتهای سختگیرانه برای پردازش یک پرس و جو در زمان واقعی و بهطور پیشفرض به ساختارمندترین و با رتبهترین منابع موجود کار میکنند. بدون اطلاعات واضح، صفحات مبهم – پرش به منبع بعدی. اگر محتوای شما در این بخش محدود نباشد، رتبه پایین تری کسب نمی کند. هیچ رتبه ای نمیگیره
از میلیاردها صفحه ای که به صورت آنلاین وجود دارد، تنها بخش کوچکی به طور مداوم بازیابی شده و برای استناد هوش مصنوعی قابل استفاده است. بسیاری از وبسایتها مملو از کدهای غیرضروری، سازماندهی ضعیف، بارگیری کند، یا از نظر فنی تکهتکه شدهاند به گونهای که بازیابی دستگاه را دشوار میکند. بسیاری از سیستمهای هوش مصنوعی محاورهای به شدت به نمایههای جستجوی سنتی برای زمینگذاری زنده و بیدرنگ وابسته هستند. اگر یک وبسایت نتواند به روشی متعارف رتبهبندی یا فهرستبندی کند، عملاً از جریانهای داده زنده که این موتورهای پاسخ هوش مصنوعی ترکیبی را نیرو میدهند، قطع میشود. دو لایه دید به هم متصل هستند. شکست یکی به معنای شکست هر دو است.
این بدان معنی است که داده های حقوق بشر، اطلاعات قانونی تأیید شده یا تحقیقات مبتنی بر شواهد که صرفاً برای بازیابی ماشینی ساختاری ندارند، بی ارزش نمی شوند. کاملا قطع کنید. اگر یک وبسایت فاقد نشانههای فنی باشد که ماشینها به آنها متکی هستند – نشانهگذاری دادههای ساختاریافته، تعریف شی واضح، سلسلهمراتب اطلاعات منطقی و سازماندهی منسجم- ممکن است هرگز وارد پنجره باریک دیدی که سیستمهای هوش مصنوعی برای فرمولبندی پاسخهای خود استفاده میکنند، نشود. و منبعی که هرگز وارد این پنجره نمی شود وجود ندارد – نه برای دستگاه، و بنابراین نه برای شخصی که سؤال می کند.
چه کسی بیشترین هزینه نامرئی فنی را متحمل می شود
این یک زمین بازی برابر نیست. خوانایی ماشین به طور فزاینده ای توسط منابع شکل می گیرد تا ارتباط یا زمینه دنیای واقعی. پلتفرم های بزرگ با ظرفیت فنی قابل توجه محتوای تمیزتر و ساختارمندتری تولید می کنند زیرا می توانند برای دستیابی به استانداردهای فنی در حال توسعه سرمایه گذاری کنند.
در نتیجه، سازمانهایی که فاقد این منابع هستند، اغلب آنهایی هستند که صدایشان مهمتر است، مانند مدافعان حقوق بشر، سازمانهای کمک حقوقی، جنبشهای مردمی بدون تیمهای توسعه اختصاصی، کسبوکارهای محلی با تخصص فنی محدود و اولویتهای رقابتی، و تولیدکنندگان محتوا یا صداهای معتبر که خارج از جریان اصلی فعالیت میکنند.
بیشتر سازمانها همچنان بر بهینهسازی سطحی – طراحی بصری، حضور در رسانههای اجتماعی، سئوی اولیه – متمرکز هستند، در حالی که از پایههای ساختاری که تعیین میکنند ماشینها اصلاً میتوانند آنها را بیابند، بخوانند و به آنها اعتماد کنند، چشمپوشی میکنند. الزامات فنی به سرعت در حال تکامل هستند و بسیاری از سازمان ها یا مشکل را دست کم می گیرند یا به سادگی نمی دانند چه چیزی باید برطرف شود.
این مهم در زمان تبدیل است. اکتشاف مبتنی بر هوش مصنوعی به طور فزاینده ای با تصمیمات با هدف بالا مرتبط است – حمایت از یک سازمان، خرید، اهدا، یا انتخاب ارائه دهنده خدمات. کاربران گاه به گاه می توانند جستجوهای کلی را بررسی کنند، اما تصمیم گیرندگان – و عوامل هوش مصنوعی که از طرف آنها عمل می کنند – از دستورات بسیار دقیق تر و با هدف بالا استفاده می کنند که تخصص ساختاریافته، حوزه قضایی، گواهینامه ها، ارتباط پرونده و داده های سازمانی تأیید شده را مقایسه می کند. هر چه ریسک تصمیم بالاتر باشد، هوش مصنوعی برای فرمولبندی پاسخ خود به سیگنالهای ساختاریافته و قابل تأیید بیشتر متکی است. سازمانی که در این مرحله از نظر فنی نامرئی است، نه تنها رتبهبندیها را از دست میدهد، بلکه تبدیلش را به طور کامل از دست میدهد بدون اینکه بداند در نظر گرفته شده است.
سازمانها برای اینکه در این جستارهای عمیقتر مبتنی بر هوش مصنوعی قابل مشاهده باشند، به پایههای فنی قوی، دادههای قابل خواندن توسط ماشین ساختیافته و یک معماری شی واضح نیاز دارند که سیستمهای هوش مصنوعی بتوانند با اطمینان آن را استخراج و تأیید کنند. آرای تایید شده به طور سیستماتیک حذف می شوند نه به این دلیل که اعتبار ندارند، بلکه به این دلیل که خوانایی کد ندارند. اگر یک عامل هوش مصنوعی نتواند به وضوح سازمانی را از طریق سیگنالهای قابل خواندن توسط ماشین شناسایی و تأیید کند، در عوض به منابع جایگزین یا دادههای آموزشی احتمالی تکیه میکند – و حتی زمانی که یک مؤسسه ظاهر میشود، ممکن است قبلاً کنترل روایت خود را از دست داده باشد.
ملاحظات اخلاقی در مورد هوش مصنوعی
این دیگر یک مشکل فناوری اطلاعات نیست – یک مشکل اخلاقی است. موتورهای هوش مصنوعی فقط اطلاعات را پیدا نمی کنند. آن را بازسازی می کنند. وقتی منابع اصلی دارای برچسب فنی نباشند چه اتفاقی میافتد؟ و چرا خوانایی ماشین یک موضوع اخلاقی است نه فقط یک موضوع فنی؟
ظهور ابزارهای هوش مصنوعی مجموعه ای از سوالات را به همراه دارد که پاسخ دادن به آنها دشوار است. چه کسی محتوای تولید شده توسط هوش مصنوعی را در اختیار دارد، به خصوص زمانی که به شدت از مطالب دارای حق نسخه برداری استفاده می کند؟ چگونه تعصب انسانی را که در دادههایی که مدلهای زبان بزرگ از آنها آموخته میشوند، حساب کنیم؟ هیچ پاسخ ساده ای وجود ندارد و قوانین، استانداردهای صنعت و هنجارهای حرفه ای هنوز در حال تطبیق هستند. آنچه در حال حاضر اهمیت دارد این است که ما به جای اینکه آنها را به عنوان مشکل شخص دیگری در نظر بگیریم که بعداً آن را حل کنیم، فعالانه با این مسائل بسازیم. سه حوزه سزاوار توجه ویژه هستند.
- مالکیت محتوا و حق نشر: حق نسخهبرداری از آثار اصلی نویسندگی محافظت میکند، و قوانین بهطور گسترده در کشورهای مختلف متفاوت است – بسیاری از آنها به طور فعال در مورد نحوه اعمال قوانین موجود در مورد محتوای تولید شده توسط هوش مصنوعی بحث میکنند. قبل از اینکه چیزی را منتشر کنید که با کمک هوش مصنوعی ایجاد شده است، باید بتوانید صادقانه به یک سوال پاسخ دهید: آیا حق چاپ کسی را نقض می کند؟ تعیین پاسخ اغلب دشوارتر از آنچه در ابتدا به نظر می رسد است، به خصوص زمانی که خروجی هوش مصنوعی به دقت موادی را که روی آن آموزش دیده است منعکس می کند.
- تعصب و تبعیض: سیستمهای هوش مصنوعی توسط انسانها ساخته میشوند و بر اساس دادههای جمعآوریشده توسط انسان آموزش میبینند، به این معنی که تعصبات انسانی و کلیشههای مضر را میتوان در مدل جذب کرد و در خروجی آن بازتولید کرد. هر تیمی که ابزارهای هوش مصنوعی را ایجاد می کند یا به کار می گیرد باید یک فرآیند واضح برای شناسایی و کاهش نتایج مغرضانه قبل از رسیدن به کاربران داشته باشد.
- حریم خصوصی و امنیت: ارسال دادهها به APIهای ابری شخص ثالث باعث ایجاد نوردهی میشود که ممکن است در یک پشته صرفاً داخلی وجود نداشته باشد. هنگامی که اطلاعات حساس یا شخصی در میان باشد، خطرات حتی بیشتر می شود. انتقال داده ها باید ایمن باشد، دسترسی باید کنترل شود و سیستم ها باید به طور مداوم نظارت شوند – یک بار پیکربندی نشده و ایمن فرض شوند.
این نگرانی ها به مالکیت محتوا و پردازش داده ها ختم نمی شود. یک بعد اخلاقی عمیق تری در مورد اینکه سیستم های هوش مصنوعی چگونه اطلاعات را به نمایش می گذارند – یا نمی بینند – وجود دارد. در دنیایی که هوش مصنوعی به سرعت در حال تبدیل شدن به لنز اصلی است که افراد از طریق آن به دانش دسترسی دارند، توانایی شناسایی، نسبت دادن و استناد به درستی دیگر جزییات فنی جزئی نیست. این یک موضوع عدالت معرفتی است، حق اساسی چه کسی باید در وهله اول به عنوان منبع دانش شناخته شود.
مشکل اجماع و سرکوب صدای اقلیت ها
برای جلوگیری از تولید اطلاعات نادرست، مدلهای زبانی بزرگ به دنبال اجماع در سراسر وب هستند – رایجترین، تکراریترین پاسخ با بیشترین حجم. این مکانیسم یک عارضه جانبی جدی دارد. به طور سیستماتیک حذف می کند:
- تفاوت های ظریف – نظرات کارشناسی که با اکثریت محبوب اما بالقوه نادرست موافق نیست
- صداهای اقلیت – دیدگاههای فرهنگی، منطقهای یا به حاشیه راندهشده که به سادگی حجم یکسانی از دادههای آنلاین را ندارند
- نوآوری – ایده های جدید یا مخرب که هنوز به اجماع نرسیده اند
اگر از جمعیت بپرسید بهترین غذا چیست، پاسخ ممکن است پیتزا باشد. این یک پاسخ مطمئن است، اما کل دنیای غذاهای جهانی را نامرئی می کند. پویایی یکسانی به صورت آنلاین انجام می شود: پلتفرم های بزرگ با بودجه محتوای قابل توجه بر پاسخ های تولید شده توسط هوش مصنوعی تسلط دارند، نه به این دلیل که محتوای آنها دقیق تر یا ارزشمندتر است، بلکه به این دلیل که بیشتر توسط ماشین قابل خواندن است.
حق کشف شدن
از نظر تاریخی، سانسور به معنای سرکوب حق آزادی بیان بوده است. در عصر هوش مصنوعی، سانسور به طور فزاینده ای به معنای کنترل حق کشف شدن است. ما در عصر سر و صدای بی پایان زندگی می کنیم که هر کسی می تواند پست بگذارد، اما عوامل هوش مصنوعی مستقل به عنوان لایه مرتب سازی نهایی برای توجه انسان عمل می کنند. اگر فاقد زیرساخت فنی برای عبور از این فیلتر هستید، عملاً بهطور پیشفرض ساکت میشوید، نه با تصمیم انسانی، بلکه با نامرئی بودن الگوریتمی.
ابعاد قانونی و نظارتی
بر اساس قوانین نوظهور سوئیس و قانون هوش مصنوعی اتحادیه اروپا، فشار نظارتی قابل توجهی برای پاسخگویی و داده های نماینده برای جلوگیری از تبعیض الگوریتمی وجود دارد. موتورهای جستجو از نظر قانونی مسئول انتشار اطلاعات نادرست هستند. برای محافظت از خود، این سیستمها به طور فزایندهای منابعی را که نمیتوانند استانداردهای بالای منشأ دادهها را نشان دهند، فیلتر میکنند – منابعی که نمیتوانند به وضوح ثابت کنند که اطلاعاتشان از کجا آمده است. عدم رعایت تنها یک خطر اخلاقی نیست. این یک ریسک قابل مشاهده با مبنای قانونی است.
تنش حقوقی دیگر مربوط به حق فراموشی است. در موتورهای جستجوی سنتی، این حق برقرار و قابل اجرا است – یک شخص یا سازمان می تواند درخواست کند که این پیوندها از نتایج جستجو حذف شوند. هوش مصنوعی درمان مشابهی را ارائه نمی دهد. هنگامی که اطلاعات در داده های آموزشی مدل جذب می شود، نمی توان آن را به طور انتخابی واگرد کرد. هیچ ورودی فهرستی برای حذف و هیچ پیوندی برای حذف وجود ندارد. این اطلاعات به بخشی از درک آماری مدل از جهان تبدیل میشود و بهطور نامرئی در پاسخهایی که تولید میکند جای میگیرد.
این یک عدم تقارن اساسی ایجاد می کند: حق کشف ممکن است به تلاش فنی قابل توجهی برای اثبات نیاز داشته باشد، در حالی که حق فراموش شدن، زمانی که به خوبی محافظت شود، در زمینه هوش مصنوعی مولد به شدت تضعیف می شود و اجرای آن تا حد زیادی در عمل حل نشده باقی می ماند.
تعهدات شرکتی و بشردوستانه
اطمینان از خوانایی ماشین دیگر یک راه حل صرفا IT نیست. این یک تعهد شرکتی و بشردوستانه است – پیش نیازی برای اطمینان از اینکه حقیقت، انطباق و حمایت انسانی واقعاً در عصر هوش مصنوعی قابل کشف، اعتبار و محافظت است. انتخابهای فنی در مورد چگونگی ساختار و برچسبگذاری محتوا، واقعاً انتخابهایی هستند که دانش چه کسی مهم است و صدای چه کسی شنیده میشود.
آنچه می توانید انجام دهید: یک چارچوب عملی برای دید هوش مصنوعی
وب سایت شما دیگر یک بروشور دیجیتالی برای چشم انسان نیست. این یک پایگاه اطلاعاتی ساختار یافته است که برای جذب توسط ماشین ها طراحی شده است. قبل از اینکه حتی به بازاریابی خلاقانه یا طراحی UX فکر کنید، سایت شما باید یکپارچگی فنی مطلق داشته باشد. در یک محیط مبتنی بر هوش مصنوعی، اگر معماری دادههای شما به هم ریخته باشد، موتورهای جستجوی هوش مصنوعی – Perplexity، ChatGPT، Google – آن را نادیده میگیرند یا آن را اشتباه تفسیر میکنند. آمادگی فنی دیگر یک مزیت رقابتی نیست. اینم بلیط ورودی
نقطه شروع یک چارچوب تشخیصی ساده است: سه C از آمادگی هوش مصنوعی.
- آیا عوامل هوش مصنوعی می توانند شما را پیدا کنند؟
- وقتی شما را پیدا کردند، می توانند شما را درک کنند؟
- وقتی شما را پیدا کردند و درک کردند، آیا می توانند به شما اعتماد کنند؟
این سه سؤال مستقیماً به چهار ستون عملی – دو پایه فنی و دو مرتبط با محتوا – مرتبط هستند که تعیین می کنند آیا سازمان شما در وب مبتنی بر هوش مصنوعی وجود دارد یا خیر.
رکن 1: آمادگی فنی
اساس این است که چگونه وب سایت شما بر روی ماشین ها ساخته و ارائه می شود. به آن به عنوان تفاوت بین یک کابینت بایگانی سازماندهی شده و انبوهی از اسناد شل روی میزتان فکر کنید—ممکن است اطلاعات یکسان باشد، اما فقط یکی را می توان به طور مؤثر جستجو کرد.
در عمل به این معنی است:
- اطلاعات مهم را از قبل بارگیری کنید. سیستمهای هوش مصنوعی در محدودیتهای پردازشی سختگیرانه عمل میکنند. اگر مهمترین محتوای شما – چه کسی هستید، چه کار میکنید، کجا کار میکنید – در کدی قرار دارد که تنها پس از تعامل کاربر با صفحه بارگیری میشود، ماشینها منتظر آن نمیمانند. آنها ادامه خواهند داد. اطلاعات کلیدی شما باید قبل از هر گونه تعاملی در ساختار صفحه اولیه قابل مشاهده برای ماشین ها باشد.
- از تگ های صفحه تمیز و توصیفی استفاده کنید. متا تگ ها – تگ های توصیفی کوتاه متصل به هر صفحه که انسان به ندرت می بیند اما ماشین ها همیشه می خوانند – باید به طور دقیق و مشخص محتوای هر صفحه را توصیف کنند. آنها را به عنوان یک برچسب پوشه پشتیبان در نظر بگیرید: برچسب های نامشخص یا گم شده به این معنی است که پوشه در حال رد شدن است.
- ساخت با HTML معنایی. HTML کدی است که صفحه شما را ساختار می دهد. HTML معنایی به معنای استفاده از بلوکهای ساختاری مناسب برای هر نوع محتوا – عناصر دکمهای مناسب برای دکمهها، عناصر پیوند مناسب برای پیوندها، سطوح عنوان مناسب برای سرفصلها – بهجای اجبار ظروف عمومی برای انجام عملکردهایی که برای آنها طراحی نشدهاند. ماشین ها برای تشخیص بلوک های ساختمانی استاندارد آموزش دیده اند. غیر استاندارد باعث ایجاد ابهام می شود. هنگامی که یک عامل با یک عنصر بصری روبرو می شود که شبیه یک دکمه است اما به این صورت کدگذاری نشده است، ممکن است اصلا آن را به عنوان تعاملی تشخیص ندهد. اگر نمی توان از HTML استاندارد استفاده کرد، حداقل باید به عنصر یک برچسب نقش صریح داده شود که به موتورها بگوید قصد انجام چه کاری را دارد.
- یک چیدمان ثابت و ثابت را حفظ کنید. عوامل هوش مصنوعی که به صورت بصری صفحات شما را تجزیه و تحلیل می کنند، اگر همان عنصر – یک دکمه کلید، یک منوی پیمایش، یک فیلد فرم – در مکان دیگری در صفحات مختلف ظاهر شود، گیج خواهند شد. سازگاری فقط یک اصل طراحی نیست. این یک اصل خوانایی ماشین است. عاملی که نتواند به طور قابل اعتماد عنصری را در صفحات پیدا کند، اعتماد خود را به سایت از دست خواهد داد.
- موارد پنهان یا نامرئی را حذف کنید. پوشش های شفاف، منوهای پنهان و عناصر پنهان در پشت سایر محتواها به طور موثر دیوارهای نامرئی را برای تجزیه و تحلیل ماشین ایجاد می کنند. اگر یک عنصر تعاملی از نظر بصری پنهان باشد، عواملی که تجزیه و تحلیل بصری انجام می دهند می توانند آن را به طور کامل رد کنند – حتی اگر از نظر فنی در کد وجود داشته باشد. هر عنصری که برای سفر کاربر اهمیت دارد باید به وضوح قابل مشاهده و در دسترس باشد.
- عناصر تعاملی را به اندازه کافی بزرگ کنید تا شناخته شوند. تجزیه و تحلیل بصری توسط عوامل هوش مصنوعی، عناصری را که برای تفسیر معنادار بسیار کوچک هستند، فیلتر می کند. هر عنصر تعاملی – دکمه، پیوند، فیلد فرم – که برای انجام یک عمل مورد نیاز است باید دارای یک منطقه قابل مشاهده به اندازه کافی بزرگ باشد تا در تجزیه و تحلیل بصری ثبت شود. عناصر کوچکتر از چند پیکسل در هر ابعادی در خطر فیلتر شدن کامل هستند.
- کنترل کنید چه کسی به داده های شما دسترسی دارد. هر ربات موجود در وب نباید دسترسی نامحدود به سایت شما داشته باشد. با پیکربندی فایل robots.txt خود – مجموعهای ساده از دستورالعملها که به روباتها میگوید چه چیزی هستند و به چه چیزی اجازه دسترسی ندارند – میتوانید بهطور انتخابی مانع جذب برخی از خراشندههای هوش مصنوعی در دادههای آموزشی خود شوید، در حالی که اطلاعات نام تجاری عمومی خود را برای کشف باز نگه دارید. این در مورد پنهان شدن از هوش مصنوعی نیست. این در مورد کنترل این است که کدام سیستم های هوش مصنوعی از داده های شما سود می برند و چگونه. برای سازمانهای خاص صنعت، آمادگی فنی همچنین به معنای دسترسی به رباتهای تخصصی است که مدلهای بزرگتر را تامین میکنند – نه فقط رباتهای همهمنظوره.
- یک نقشه راه روشن برای زمینه هوش مصنوعی تعریف کنید. در حالی که شما کنترل می کنید که چه کسی به داده های شما دسترسی داشته باشد، شما کنترل می کنید که عوامل هوش مصنوعی کجا بروند نمی تواند برای اطمینان از اینکه آنها به طور دقیق اطلاعات شما را ترکیب می کنند، یک نقشه فعال مورد نیاز است. این جایی است که در حال ظهور است
llms.txtاین استاندارد به یک ستون فنی کلیدی برای سازمان ها و سازمان های غیر انتفاعی تبدیل می شودllms.txtfile یک فایل تمیز و مبتنی بر علامت گذاری است که در فهرست اصلی وب سایت شما قرار می گیرد. این یک شاخص مختصر و با چگالی بالا از مهم ترین اطلاعات در مورد سایت شما را ارائه می دهد که به ویژه برای پردازش توسط LLM و عوامل مرورگر مستقل فرمت شده است.
ستون 2: ترجمه معنایی و SEO مبتنی بر شی
مدلهای هوش مصنوعی مانند موتورهای جستجوی سنتی دنیا را از طریق کلمات کلیدی درک نمیکنند. آنها روابط بین اشیاء را ترسیم می کنند – چیزهای متمایز و قابل تشخیصی که در جهان وجود دارند: افراد، سازمان ها، مکان ها، مفاهیم، رویدادها. سوالی که یک سیستم هوش مصنوعی همیشه سعی میکند به آن پاسخ دهد این نیست که “آیا این صفحه حاوی این کلمات است”، بلکه “آیا میدانم این سازمان چیست، چه کار میکند، به چه کسانی خدمات میدهد و چگونه با چیزهای دیگری که قبلاً میشناسم ارتباط دارد؟”
اینجاست که نشانه گذاری طرحواره ابزار قدرتمند شما می شود. به نشانه گذاری طرحواره به عنوان یک لایه ترجمه بین محتوای شما و ماشین هایی که آن را می خوانند فکر کنید. این یک واژگان استاندارد شده از کد است که شما به وب سایت خود اضافه می کنید تا به طور صریح حقایق مربوط به سازمان خود را به زبانی که ماشین ها برای خواندن آن طراحی شده اند بیان کنید. به جای اینکه یک سیستم هوش مصنوعی استنباط کند که شما یک سازمان کمک حقوقی مستقر در ژنو هستید، نشانه گذاری طرحواره به طور مستقیم و بدون ابهام آن را همراه با زمینه های تخصص، روابط سازمانی و ویژگی های کلیدی شما بیان می کند.
نشانه گذاری طرحواره پیشرفته متن وب سایت بدون ساختار را به یک فید ماشین سازمان یافته تبدیل می کند. این به عنوان پلی بین سایت شما و نمودارهای دانش هوش مصنوعی جهانی عمل می کند – پایگاه داده های عظیم به هم پیوسته ای که موتورهای جستجو برای تأیید حقایق در مورد جهان استفاده می کنند. هنگامی که یک سیستم هوش مصنوعی دامنه یا صنعت شما را جستجو میکند، نشانهگذاری طرحواره چیزی است که تضمین میکند سازمان شما را بهعنوان منبعی کاملاً تعریفشده، متصل و معتبر میبیند که میتواند با اطمینان به آن استناد کند.
رکن 3: کسب اطلاعات
شما نمی توانید پلتفرم های بزرگ را با حجم زیاد محتوا شکست دهید. شما می توانید از منحصر به فرد بودن و تراکم سود ببرید.
موتورهای هوش مصنوعی به طور فعال محتوایی را جستجو میکنند که حقایق یا دیدگاههایی را معرفی میکند که قبلاً در دادههای آموزشی آنها وجود ندارد – مفهومی که به عنوان کسب اطلاعات شناخته میشود. به این موضوع فکر کنید: اگر یک سیستم هوش مصنوعی قبلا هزاران مقاله را هضم کرده است که همان نکته کلی را دارند، مقاله دیگری که همان نکته را بیان می کند چیزی اضافه نمی کند. نادیده گرفته خواهد شد. چیزی که نادیده گرفته نمیشود محتوایی است که در هیچ جای دیگری وجود ندارد – دادههای خام حاصل از کار میدانی خودتان، مطالعات موردی اختصاصی، یافتههایی که با اجماع جریان اصلی مخالفت میکنند و دیدگاههای تخصصی بسیار خاص بر اساس تجربه دست اول.
برای سازمان های کوچکتر و غیر انتفاعی، این در واقع یک مزیت ساختاری است. گزارش های میدانی شما، تجربه زیسته شما، تحقیقات اولیه و مستندات دست اول شما از رویدادها دقیقاً همان نوع منبعی هستند که سیستم های هوش مصنوعی وقتی به دنبال چیزی برای استناد هستند که محتوای عمومی قادر به ارائه آن نباشد، از آنها استفاده می کنند. سازمانهایی که قبول میکنند نمیتوانند با پلتفرمهای محتوای بزرگ رقابت کنند، اغلب خود را با ارزشمندترین محتوا میبینند – آنها فقط آن را به گونهای ساختار و منتشر نکردهاند که ماشینها بتوانند آن را پیدا و استخراج کنند.
رکن 4: نشانه های اعتماد و اثبات انسانیت
همانطور که محتوای تولید شده توسط هوش مصنوعی به وب سرازیر می شود، هم کاربران انسانی و هم سیستم های هوش مصنوعی در تشخیص آن بهتر می شوند و نسبت به آن بدبین تر می شوند. مصرف کنندگان در حال توسعه چیزی هستند که می توان آن را خستگی هوش مصنوعی نامید: ترجیح فزاینده برای محتوایی که دارای بافت غیرقابل انکار تجربه واقعی انسانی است. موتورهای جستجوی هوش مصنوعی با جستوجوی فعالانه سیگنالهایی مبنی بر اینکه محتوا از یک فرد واقعی با دانش واقعی و تجربه واقعی میآید، بر این اساس سازگار میشوند.
چارچوب E-E-A-T Google – که مخفف Experience, Expertise, Authority, and Trust است- واضحترین رمزگذاری این تغییر است. این تلاشی است برای آشکار ساختن محتوایی که ماشینها نمیتوانند به طور واقعی بازتولید کنند، زیرا هوش مصنوعی نمیتواند تجربه فیزیکی داشته باشد، یک مصاحبه اولیه واقعی انجام دهد، یک جامعه واقعی بسازد یا دارای مدرک حرفهای باشد که با سالها تمرین به دست آمده است.
سازمان های کوچکتر و غیر انتفاعی باید دقیقاً بر این تکیه کنند. تک تک کارشناسان و رهبران خود را به صورت برجسته و با نام معرفی کنید. محتوای ویدیویی و صوتی را منتشر کنید که بافت یک مکالمه واقعی را داشته باشد. اسناد پشت صحنه کار خود را به اشتراک بگذارید. با نظر، ذهنیت و ویژگی بر اساس تجربه مستقیم بنویسید. عکس اورجینال به سفارش انجمن های اجتماعی ایجاد کنید که در آن افراد واقعی دیدگاه های واقعی را تبادل کنند. اینها قالبهایی هستند که دقیقاً به این دلیل برجسته میشوند که بازتولید متقاعدکنندهای برای هوش مصنوعی سختترین شکلها هستند – و بنابراین قالبهایی که هم خوانندگان انسانی و هم سیستمهای هوش مصنوعی به طور فزایندهای آموزش میبینند تا به آنها اعتماد کنند.
ابتدا با ایجاد یکپارچگی فنی و تقویت آن با محتوای منحصر به فرد و سیگنال های اعتماد واقعی انسان، اطمینان حاصل می کنید که برتری دنیای واقعی شما کاملاً قابل مشاهده است، به درستی نسبت داده می شود و نادیده گرفتن آن برای ماشین ها غیرممکن است. سازمان هایی که اکنون در این زمینه عمل می کنند، به سادگی از تغییر به جستجوی مبتنی بر هوش مصنوعی جان سالم به در نخواهند برد. آنها تعیین خواهند کرد که چه کسی در مورد آن شنیده می شود.
تعاریف و سوالات متداول
ذات چیست؟
در زمینه هوش مصنوعی و جستجوی معنایی، یک موجودیت هر چیز متمایز و قابل شناسایی است که در جهان وجود دارد و می تواند به طور واضح تعریف شود – یک شخص، سازمان، مکان، محصول، مفهوم یا رویداد. چیزی که چیزی را به یک شی تبدیل میکند فقط نام آن نیست، بلکه مجموعهای قوی از ویژگیها و روابط است که ماشینها میتوانند نقشهبرداری و بررسی کنند. سازمان شما یک شخص حقوقی است. مدیر عامل شما یک شخص حقوقی است. حوزه قضایی که در آن فعالیت می کنید یک شخص حقوقی است.
یک مثال ساده نشان می دهد که چرا این موضوع اهمیت دارد: کلمه “Apple” برای یک ماشین بدون تشخیص ابهام شیء به معنای چیزی نیست. آیا این میوه است؟ شرکت فناوری؟ شرکت ضبط موسیقی که توسط بیتلز تأسیس شد؟ مردم بلافاصله از روی زمینه تصمیم می گیرند. ماشینها به نشانههای صریح – ویژگیها، روابط و دادههای ساختاریافته – نیاز دارند تا مشخص کنند کدام اپل ذکر شده و آن را به مجموعه درستی از حقایق متصل کند. این تشخیص شی است: توانایی تشخیص نه فقط کلمات، بلکه تک تک چیزهای دنیای واقعی که آن کلمات به آنها اشاره دارند.
هنگامی که سیستمهای هوش مصنوعی سعی میکنند وبسایت شما را بفهمند، آنها آنطور که یک انسان میخواند آن را نمیخوانند – آنها به دنبال اشیایی میگردند که میتوانند تشخیص دهند، با سایر اشیاء شناختهشده مرتبط باشند و در برابر نمودارهای دانش مانند نمودار دانش Google یا ویکیداده اعتبارسنجی کنند. یک وبسایت پر از متنهای قابل خواندن برای انسان، اما بدون اشیاء به وضوح تعریف شده، از دیدگاه یک ماشین، مجموعهای از کلمات بیمعنی است. بدون وضوح موضوع، یک سیستم هوش مصنوعی میتواند هویت شما را به اشتباه شناسایی کند، شما را با سازمان دیگری مرتبط کند، یا به سادگی نتواند شما را در هیچ زمینه معناداری قرار دهد – و موجودی که نمیتواند با اطمینان شناسایی کند، موجودی است که به آن استناد نمیکند.
نشانه گذاری طرحواره چیست و چرا مهم است؟
نشانه گذاری طرح واژگان استاندارد شده ای از کد است که در Schema.org توسعه یافته و توسط موتورهای جستجوی بزرگی مانند گوگل و مایکروسافت پشتیبانی می شود که شما آن را به وب سایت خود اضافه می کنید تا به صراحت حقایق مربوط به محتوای خود را بیان کنید و زبان بدون ساختار انسانی را به یک فید داده سازمان یافته تبدیل کنید که سیستم های هوش مصنوعی می توانند فوراً آن را تأیید کنند.
وقتی شخصی که صفحه اصلی شما را می خواند متوجه می شود که شما یک سازمان کمک حقوقی مستقر در ژنو هستید، یک ماشین بدون نشانه گذاری طرحواره باید بداند. با علامت گذاری طرحواره خود، آن را مستقیماً به زبانی بیان می کنید که ماشین ها برای خواندن آن طراحی شده اند: نوع سازمانی که هستید، کجا کار می کنید، چه کسی آن را اجرا می کند، چه خدماتی را ارائه می دهید و چگونه همه این عناصر با یکدیگر مرتبط هستند. به آن به عنوان یک لایه ترجمه بین محتوای انسان و هوش ماشینی فکر کنید که سعی در تفسیر آن دارد. نشانه گذاری طرحواره چیزی است که وب سایت شما را از یک سند مبهم به یک منبع داده ساختاریافته تبدیل می کند – منبعی که سیستم های هوش مصنوعی می توانند با اطمینان آن را استخراج کنند، استناد کنند و به نمودار دانش وب گسترده تر متصل شوند.
تفاوت بین موتورهای هوش مصنوعی و موتورهای جستجوی سنتی چیست؟
این تمایز به دو تفاوت اصلی منتهی می شود: نحوه ذخیره اطلاعات و نحوه بازیابی آنها هنگام پرسیدن سؤال.
موتورهای جستجوی سنتی مانند گوگل و بینگ به طور مداوم در وب می خزند، پیوندهای بین صفحات را ترسیم می کنند، و همه چیز را در یک پایگاه داده عظیم به نام فهرست معکوس ذخیره می کنند – آن را به عنوان یک فهرست کتابخانه عظیم و دائماً به روز شده در نظر بگیرید. هنگامی که شما جستجو می کنید، آنها این کاتالوگ را پرس و جو می کنند و یک لیست رتبه بندی شده از پیوندها را برمی گردانند. سرعت ظاهر شدن محتوای جدید در نتایج بسته به اعتبار سایت و تعداد دفعاتی که خزندههای Google از آن بازدید میکنند بسیار متفاوت است – سایتهای جدید یا کوچکتر ممکن است روزها یا هفتهها طول بکشد تا فهرست شوند.
سیستمهای هوش مصنوعی متنوعتر هستند و نباید به عنوان یک دسته واحد در نظر گرفته شوند.
الگوهای زبانی ناب (مانند ChatGPT بدون فعال بودن مرور) به هیچ وجه صفحات را فهرست یا ذخیره نکنید. در طول یک مرحله یادگیری، آنها حجم عظیمی از محتوای وب را میخوانند و آنچه را که میآموزند در مدلهای ریاضی به نام وزن فشرده میکنند—بهجای ذخیرهسازی صفحات واقعی، بهطور مؤثر نحوه اتصال مفاهیم را به یاد میآورند. دانش آنها تاریخ انقضا دارد و نمی توانند بدون ابزار اضافی به هر چیزی که پس از آموزش منتشر شده است دسترسی پیدا کنند.
سیستم های جستجوی هوش مصنوعی (مانند Perplexity یا Bing Copilot) متفاوت عمل می کنند. آنها یک مدل زبان را با بازیابی وب زنده ترکیب می کنند – جستجوی وب در زمان واقعی برای هر پرس و جو، بازیابی منابع مرتبط و استفاده از آنها برای ایجاد یک پاسخ مستدل و نقل شده. آنها به طور فزایندهای در میان محصولات جستجوی هوش مصنوعی مصرفکننده، معمول هستند، نه استثنا.
| مشخصه | جستجوی سنتی (گوگل، بینگ) | مدل های خالص هوش مصنوعی (ChatGPT بدون گشت و گذار) | موتورهای جستجو با هوش مصنوعی (Perplexity، Bing Copilot) |
|---|---|---|---|
| چگونه داده ها را ذخیره می کنند | نمایه معکوس زنده صفحات و URL ها | یک شبکه عصبی الگوهای رمزگذاری را از داده های آموزشی وزن می کند | وزن ها را با شاخص ها برای بازیابی زنده ترکیب کنید |
| دسترسی بلادرنگ | خزیدن مداوم؛ سرعت نمایه سازی بسته به مرجع سایت بسیار متفاوت است | بدون دسترسی زمان واقعی؛ با قطع مطالعه محدود می شود | برای هر درخواست به صورت زنده از شبکه بیرون می کشد |
| موتور جستجو | مطابقت کلمات کلیدی و رتبه صفحه | پاسخ ها را فقط از مدل های آموخته شده ایجاد می کند | منابع مرتبط را بازیابی می کند، سپس یک پاسخ مستدل ایجاد می کند |
| مانع در پردازش | سرعت خزیدن، مرتبسازی و بازیابی میلیاردها URL | هزینه تولید توکن ها را در زمان واقعی محاسبه کنید | هم تأخیر بازیابی و هم هزینه محاسباتی تولید |
| خارج شوید | لیست رتبه بندی لینک ها به صفحات خارجی | پاسخ مکالمه بر اساس داده های آموزشی | پاسخ مکالمه با نقل قول منبع زنده جاسازی شده است |
مفهوم عملی برای سازمان شما این است که دید اکنون مستلزم ارضای چندین سیستم مختلف به طور همزمان است – یک فهرست جستجوی سنتی، یک مجموعه آموزشی و یک لایه بازیابی زنده – که هر یک محتوای شما را متفاوت میخواند و ارزیابی میکند.
چگونه سیستمهای هوش مصنوعی درباره برند من چیزهایی میدانند؟
سه راه وجود دارد که نام تجاری شما می تواند در یک پاسخ تولید شده توسط هوش مصنوعی ظاهر شود.
- داده های آموزشی – “حافظه” مدل در طول آموزش، مدلها مجموعه دادههای عظیمی را از صفحات وب، کتابها، مقالات و کد دریافت میکنند. اطلاعاتی که در اینجا آموخته می شود به دانش رایجی تبدیل می شود که در مدل ساخته شده است. نکته مهم این است که این دانش تاریخ انقضا دارد، بنابراین هر چیزی که از زمان آموزش تغییر کرده یا شروع شده باشد ممکن است دیگر در حافظه مدل وجود نداشته باشد.
نتیجه گیری: این مدل می تواند مفاهیم، مارک ها و روابط را به یاد بیاورد – اما این دانش ممکن است قدیمی باشد زیرا آموزش به صورت دوره ای انجام می شود. مثال: اگر یک نام تجاری قبل از آموزش مدل به طور مکرر در شبکه ظاهر شود، احتمالاً مدل آن را به عنوان یک مفهوم “می شناسد”.
- بازیابی / RAG – “کتاب باز” سیستم های جستجوی هوش مصنوعی مدرن به طور فزاینده ای از نسل افزوده بازیابی (RAG) استفاده می کنند. به جای تکیه بر حافظه تنها، سیستم یک نمایه زنده را جستجو می کند، اسناد مربوطه را بازیابی می کند و از آنها به عنوان زمینه برای تولید پاسخ خود استفاده می کند. سیستم یک نمایه را جستجو می کند، که می تواند یک نمایه وب زنده، یک پایگاه داده مدیریت شده یا یک مخزن اسناد ثابت باشد، اسناد مربوطه را بازیابی می کند و از آنها به عنوان زمینه برای تولید پاسخ خود استفاده می کند.
نتیجه گیری: اینگونه است که سیستمهای هوش مصنوعی مرتبط و قابل تأیید میمانند. اگر سایت شما قابل خزیدن یا فهرست بندی نباشد، قابل بازیابی و استناد نیست. مثال: هنگامی که یک پاسخ هوش مصنوعی شامل منابع یا نقل قول ها می شود، معمولاً از مرحله استخراج می آیند.
- دانش ضمنی – “اثر پژواک” حتی اگر وبسایت شما مستقیماً بازیابی نشده باشد یا بهشدت در دادههای آموزشی نشان داده نشده باشد، اگر منابع دیگری در مورد شما صحبت میکنند – از جمله مقالات خبری، بررسیها، بحثهای اجتماعی، فهرست راهنمای شخص ثالث و مقالات تحقیقاتی، یک سیستم هوش مصنوعی میتواند از شما نام ببرد. در این مورد، درک مدل برای شما کاملاً از طریق این منابع ثانویه انجام می شود.
نتیجه گیری: دقت برند شما در پاسخهای هوش مصنوعی به آنچه دیگران درباره شما نوشتهاند بستگی دارد، نه آنچه در مورد خودتان میگویید. مثال: یک رستوران میتواند رباتهای هوش مصنوعی را مسدود کند، اما اگر سایتهای بررسی بزرگ درباره آن بحث کنند، هوش مصنوعی همچنان میتواند آن را بر اساس آن منابع توصیه کند.
چرا این مهم است: اگر میخواهید اطلاعات دقیقی از منبع اصلی برای پاسخهای هوش مصنوعی که برند شما را هدایت میکنند، محتوای شما قابل خزیدن، نمایهسازی و ساختاری باشد تا سیستمهای هوش مصنوعی بتوانند اشیاء شما را به درستی تفسیر کنند و واقعیت را برای شما بررسی کنند.
خطرات دیگر فقط فنی نیست
حقوق بشر، چارچوبهای قانونی و هوش مصنوعی عمیقتر از آنچه که بیشتر سازمانها تشخیص دادهاند، به هم مرتبط هستند. هوش مصنوعی از زوایای بسیاری مورد بحث است – نوآوری، بهره وری، ریسک – اما در هسته خود، بر چیز اساسی تری تأثیر می گذارد: حق ما برای دسترسی به اطلاعات، حق ما برای نمایندگی برابر، و چارچوب های قانونی طراحی شده برای محافظت از هر دو.
همانطور که هوش مصنوعی به یک عامل تبدیل می شود – به این معنی که دیگر فقط به سوالات پاسخ نمی دهد، بلکه از طرف مردم اقدام می کند – به طور رسمی در زندگی عمومی شرکت می کند. قرار ملاقات ها را ثبت می کند، درخواست ها را بایگانی می کند، توصیه ها را نمایش می دهد و موجود را فیلتر می کند. در دنیایی که مردم عمدتاً برای یافتن اطلاعات به اینترنت متکی هستند، داشتن صداهای متنوع و خوانا برای این سیستم ها ترجیح داده نمی شود. این یک ضرورت دموکراتیک است.
با این حال، مانع این مشارکت از قبل فنی است. میتوانید بیعیبترین و از نظر اخلاقی صحیحترین خطمشی حقوق بشر را بنویسید یا کسبوکاری بسازید که کاملاً با قانون مطابقت داشته باشد، اما اگر ردپای دیجیتالی سازمان شما از نظر معنایی برچسبگذاری، ساختارمند و برای ماشینها ترجمه نشده باشد، شما برای هوش مصنوعی وجود ندارید. یک عامل هوش مصنوعی نمیتواند به حقوق شما احترام بگذارد و نمیتواند مطابقت قانونی شما را ارزیابی کند، اگر در وهله اول نتواند دادههای شما را بخزد، بخواند یا درک کند.
یکپارچگی فنی بهترین نگهبان حضور شماست. قوانین خوانایی ماشینی به صورت اختیاری نیستند – آنها شرایط جدید هستند. روایت داده های خود را به یک ماشین احتمال نسپارید. معماری فنی خود را تنظیم کنید زیرا اطمینان از اینکه وب سایت شما با هوش مصنوعی صحبت می کند، فقط یک تصمیم تجاری نیست. اینگونه است که ما در عصر هوش از حقیقت، قانون و دفاع از انسان دفاع می کنیم.
از اینجا کجا برم؟
اتاق ژنو یک شروع بود. کار از اینجا ادامه دارد.
تغییر توضیح داده شده در این مقاله در راه نیست، در حال حاضر اینجاست. عوامل هوش مصنوعی اکنون فیلتر میکنند که چه کسی را شناسایی کنند، چه کسی را نقل قول کنند و نسخهای از رویدادها را بگویند. سازمان هایی که اکنون در این مورد عمل می کنند به سادگی از این تغییر جان سالم به در نخواهند برد. آنها شکل خواهند داد که چه کسی در آن شنیده می شود.
همانطور که در چارچوب عمل ذکر شده است، اگر می خواهید بدانید که سازمان شما در کجا ایستاده است، به سه سوال تشخیصی بالا مراجعه کنید. اگر در مورد پاسخ ها مطمئن نیستید، اینجا نقطه شروع است.
اگر نیاز به پشتیبانی دارید، با خیال راحت تماس بگیرید