چگونه با استفاده از Search Console API، URL Validation API و Analytics Edge همه PDFهایی را که اخیراً فهرستگشایی شدهاند پیدا کنیم.

گوگل اخیراً اقدام به فهرستگشایی گسترده فایلهای PDF کرد که اولین بار توسط ساوانا گری در لینکدین مشاهده شد. و برای بسیاری از سایتها، این فایلهای PDF در گزارشهای نمایهسازی GSC به «Crawled, Not Indexed» منتقل شدهاند. بر اساس تأثیر گسترده بر روی سایتها، به نظر میرسد که تغییر بزرگتری در سیستمهای Google باشد تا مختص این سایتها. و صادقانه بگویم، این تکان دهنده نیست. من همیشه به مشتریان گفتهام که اگر رتبهبندی محتوا در فایلهای PDF دارند، باید آن محتوا را به صورت html تغییر مسیر دهند. فایل های پی دی اف به خصوص در دستگاه های تلفن همراه دست و پا گیر هستند. آنها همچنین می توانند از نظر اندازه فایل بسیار بزرگ باشند.
با این حال، مواقعی وجود دارد که سایتها پیدیافهای طبقهبندیشده زیادی دارند و تغییر کاربری گزینه آسانی نیست. بنابراین برای آن دسته از سایتهایی که به سادگی فایلهای PDF را بدون استفاده مجدد از آنها ذخیره میکنند، ممکن است شاهد افت بسیار زیادی در برداشتها و کلیکها از فایلهای PDF بوده باشند زیرا گوگل بسیاری از آنها را در وب از فهرست خارج کرده است.
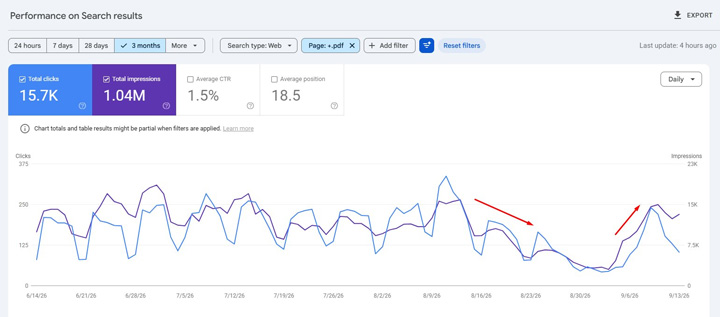
در اینجا سایتی وجود دارد که شاهد کاهش کلیک ها و نمایش فایل های pdf است (در حدود 25/8):
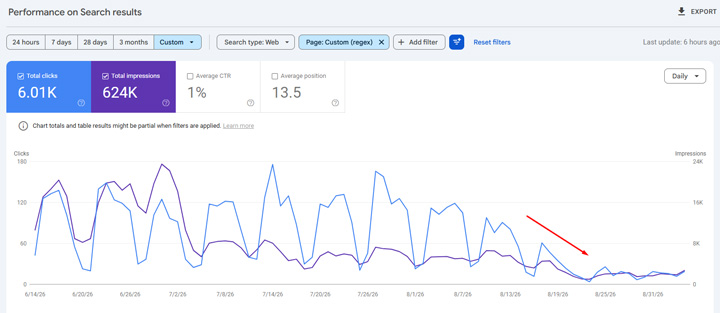
اما توجه داشته باشید که من شاهد بهبودی در برخی از سایتها هستم که در ابتدا شاهد افت شدید فایلهای PDF بودند. من می بینم که تعدادی از پی دی اف ها دوباره فهرست می شوند و کلیک ها و برداشت ها بازمی گردند. در اینجا یک مثال خوب از یک افت بزرگ و سپس یک بهبودی است. و با استفاده از فرآیند آموزش من در زیر، می توانید پی دی اف هایی را که حذف شده اند و اکنون به فهرست بازگشته اند، بیابید. این فقط یکی دیگر از مزایای انجام این فرآیند در مقیاس است. ادامه مطلب
جستجوی پی دی اف های غیر نمایه شده – پی دی اف هایی را در مقیاسی که از فهرست گوگل حذف شده اند پیدا کنید:
فرض کنید یک سایت فایل های PDF زیادی دارد. آنها واقعاً چگونه می توانند بدانند چه کسی از فهرست خارج شده است، چه کسی SERP را رتبه بندی کرده است (در مقیاس). یکی یکی رفتن چندان منطقی نیست و زمان زیادی را می سوزاند… خب، اینجاست که استفاده از قدرت API می تواند بسیار مفید باشد.
به Search Analytics API و URL Validation API (هر دو مستقیماً توسط Google ارائه شدهاند) دسترسی داشته باشید. ما قصد داریم دو آموزشی را که در گذشته ارسال کردهام ترکیب کنیم تا فرآیند یافتن فایلهای پیدیافی که فهرستزدایی شدهاند را خودکار کنیم. بله، ما فایلهای پیدیاف غیر نمایهشده را جستجو میکنیم. و توجه داشته باشید که می توانید از این روش برای پیدا کردن هر نوع فایلی که در مقیاس از فهرست خارج شده است استفاده کنید.
در پایان این درس خواهید دانست:
- همه فایلهای PDF که در SERP رتبهبندی میشوند و در طی یک دوره زمانی ترافیک جذب میکنند.
- دریابید که کدام یک از فهرست خارج شده اند و دلیل آن توسط گوگل ارائه شده است. به عنوان مثال “Crawled، not Index”، “Google Canonical متفاوتی را انتخاب کرد”، و غیره.
و خارج از این وضعیت، شما یک الگو برای بررسی وضعیت نمایه سازی URL ها در مقیاس (بدون توجه به نوع فایل، ساختار URL و غیره) تنظیم خواهید کرد.
مرحله 1: تمام فایل های PDF را از طریق Search Analytics API صادر کنید
توجه داشته باشید که اگر کمتر از هزاران فایل PDF در سایت خود رتبه بندی شده اند، نیازی به استفاده از API ندارید. رابط کاربری می تواند تا هزار ردیف داده ارائه دهد. اما اگر یک سایت بزرگتر با فایل های PDF زیادی دارید که رتبه بندی شده اند، باید از Search Analytics API استفاده کنید.
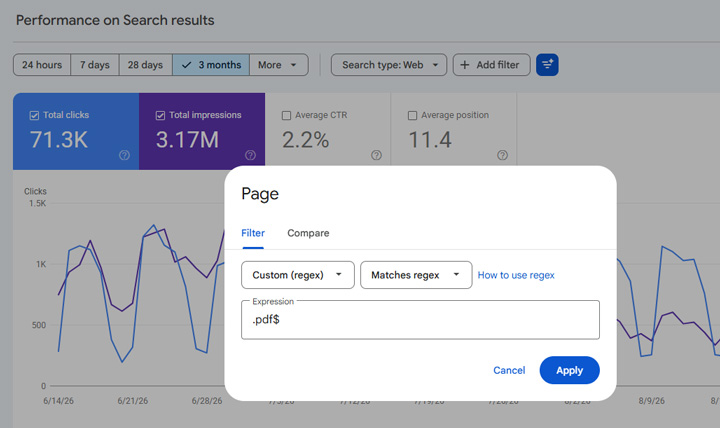
ابتدا، اگر کمتر از هزاران فایل PDF دارید، کافیست به گزارش عملکرد بروید و گزارش را برای صفحات pdf$. با استفاده از یک عبارت منظم فیلتر کنید. این به شما نشان میدهد که همه نشانیهای اینترنتی در بازه زمانی که به PDF. ختم میشوند، نمایشها و/یا کلیکهایی دریافت میکنند. اگر فایلهای pdf شما دارای پارامترهای پرس و جو بعد از pdf هستند، $ (به معنای انتهای URL از طریق regex) را حذف کنید.
برای کسانی که بیش از هزار فایل PDF دارند و یک API مورد نیاز است، به مکانیزم دسترسی API نیاز دارید. من شخصا از Analytics Edge برای استفاده از Demand Analytics API استفاده می کنم. من آموزش های زیادی در مورد نحوه استفاده از Analytics Edge با GSC نوشته ام و کار امروز بسیار ساده است. به سادگی تمام URL هایی را که برای یک دوره زمانی خاص رتبه بندی شده اند صادر کنید و توسط فایل های PDF فیلتر کنید.
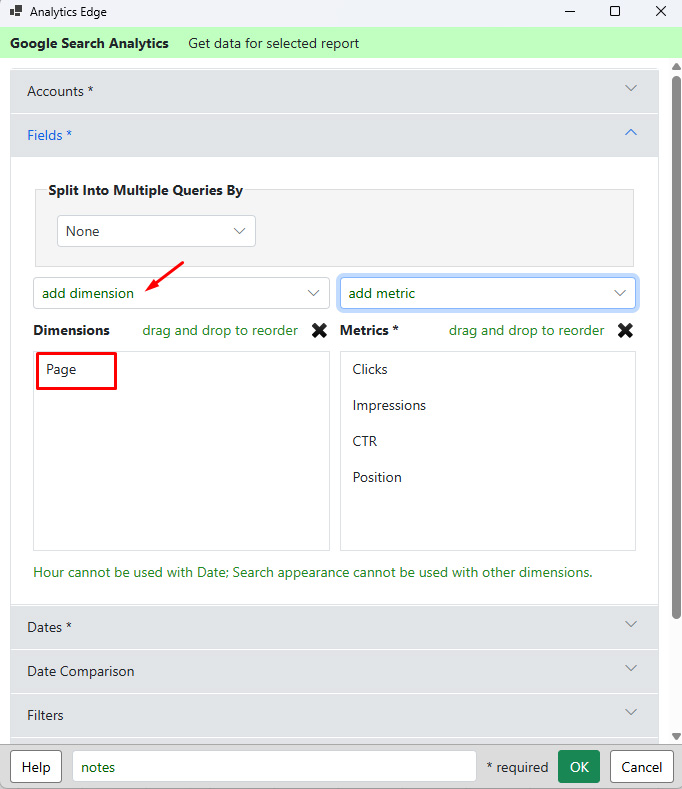
هنگام تنظیم صادرات، مطمئن شوید که «صفحه» را بهعنوان بعد اصلی انتخاب کنید و سپس هر چهار معیار (کلیکها، نمایشها، CTR و موقعیت متوسط) را انتخاب کنید.
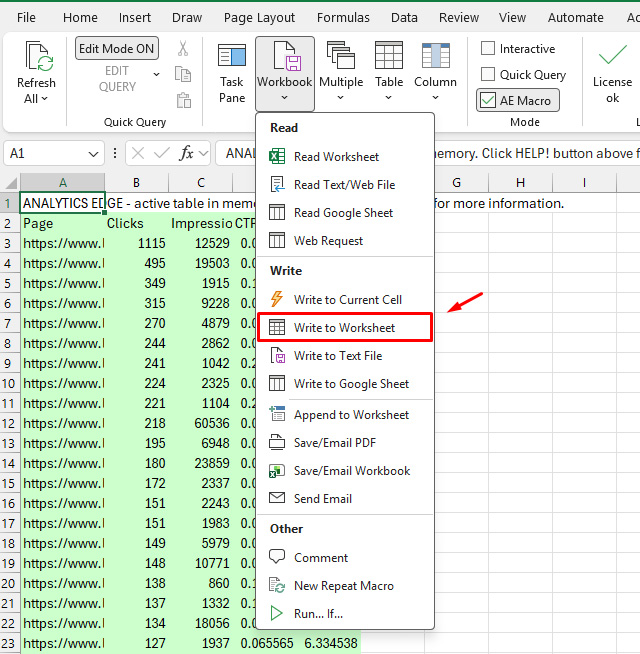
صادر کردن فقط چند ثانیه طول می کشد، سپس “ذخیره در کاربرگ” را انجام دهید تا لیست فایل های PDF شما درجه بندی شده باشد.
مرحله بعدی بررسی نمایه سازی در مقیاس است. بیایید URL Validation API را اجرا کنیم…
مرحله 2: تمام URL های PDF را از طریق URL Validation API اجرا کنید
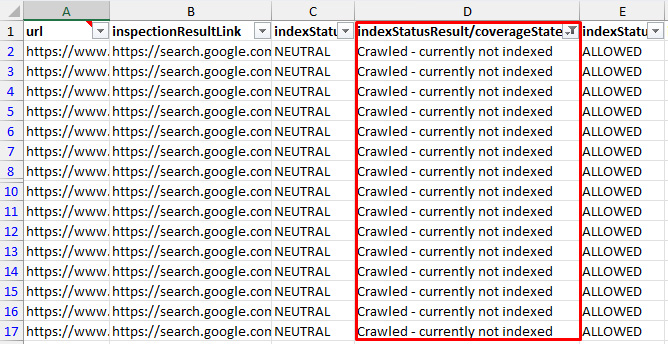
URL Checker API وضعیت فهرست هر URL را بررسی می کند. تمام اطلاعاتی را که هنگام بررسی یک URL در رابط کاربری GSC مشاهده می کنید، برمی گرداند. و مهمترین فیلد coverageState است که وضعیت نمایه سازی URL را ارائه می دهد (ایندکس شده، فهرست نشده، دلیل ایندکس نشدن و غیره) برای مثال، در اینجا می توانید ببینید که آیا صفحه ای است یا خیر. نه نمایه شده است و به عنوان «خزیده شده، نمایه نشده»، «صفحه جایگزین با متعارف مناسب» یا دلایل دیگر برای حذف از نمایه سازی دسته بندی شده است.
من چندین آموزش در مورد استفاده از URL Validation API با Analytics Edge نوشتهام، بنابراین اگر در مورد نحوه اجرای آن سردرگم هستید، میتوانید به آن مقالات مراجعه کنید.
ابتدا به یک کاربرگ حاوی تمام فایل های PDF که در مرحله اول صادر کرده اید نیاز دارید. سپس میتوانید از Analytics Edge برای استفاده از URL Checker API استفاده کنید و از تمام URLهای موجود در لیست خود استفاده کنید تا وضعیت فهرست را برای هر یک ارائه دهد. خیلی عالیه
توجه داشته باشید که محدودیت 2000 URL ویژگی در روز برای URL Validation API وجود دارد، اما اگر چندین ویژگی تنظیم کرده باشید، می توانید 2000 نشانی وب را اجرا کنید. از اموال… بنابراین اگر دارای ویژگی دامنه، ویژگی های دایرکتوری (برای پوشه ها)، ویژگی های پیشوند url و غیره مجموعه ای دارید، می توانید آدرس های اینترنتی بیشتری را در روز بررسی کنید. این یک راه حل عالی است.
در اینجا مراحل مربوط به بررسی نمایه سازی در مقیاس وجود دارد. و قطعاً آموزش های قبلی اعتبارسنجی URL API من را بخوانید تا هر مرحله را با جزئیات طی کنید. زمانی که بدانید فرآیند چگونه کار می کند انجام این کار بسیار آسان است:
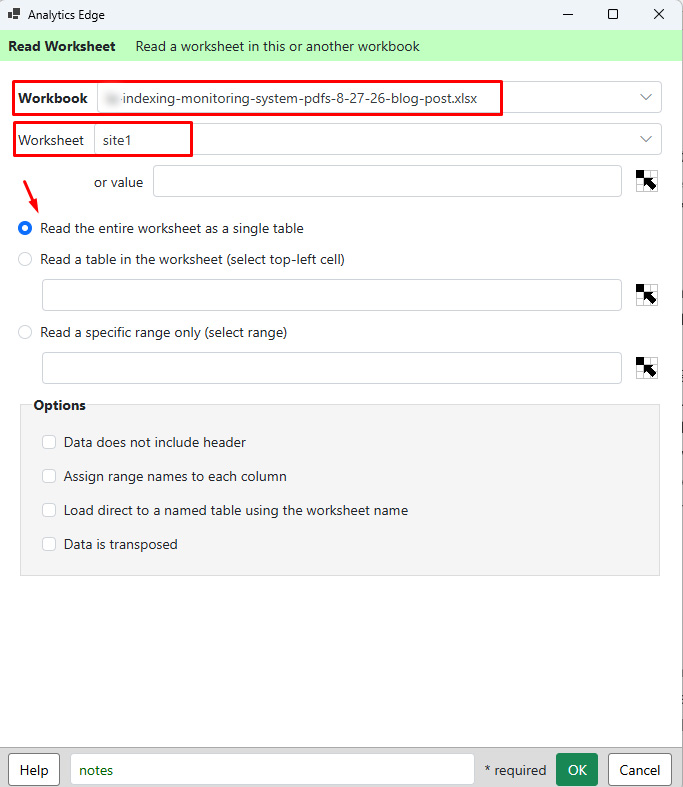
1. ابتدا از تابع ReadWorksheet برای دانلود تمام URL های PDF از اولین کاربرگ که ایجاد کرده اید و حاوی تمام فایل های PDF رتبه بندی شده در گوگل است استفاده کنید. فقط نام کاربرگ را در فیلد وارد کنید.
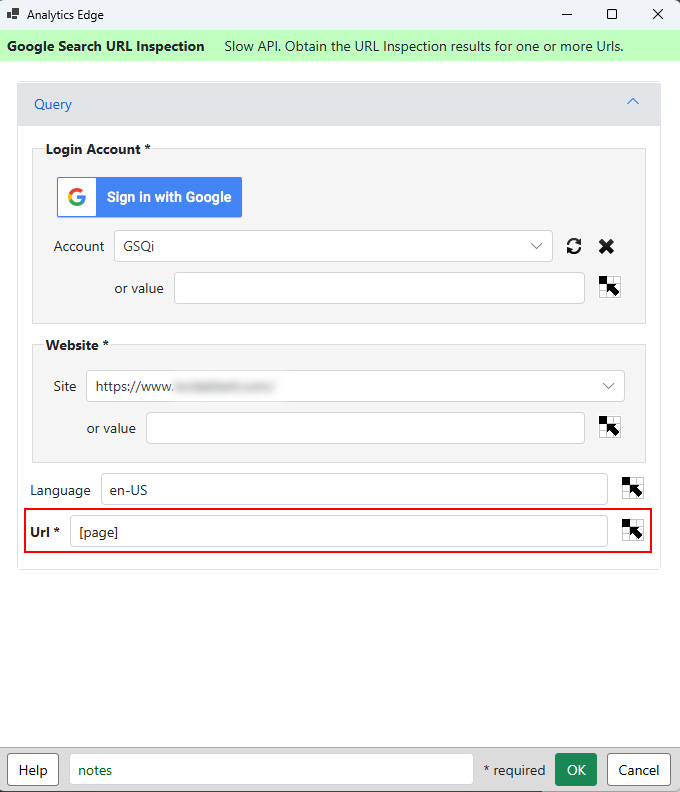
2. سپس از URL Validation API در Analytics Edge استفاده کنید و مطمئن شوید که سایت صحیح را در لیست انتخاب کرده اید و سپس هدر ستون را برای لیست URL (PDF) قرار دهید.
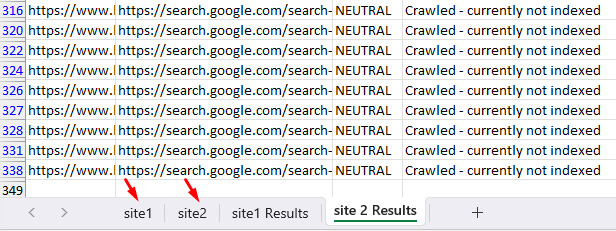
3. Analytics Edge از طریق URL ها حلقه می زند و نتایج را به حافظه صادر می کند. سپس به سادگی دوباره ‘نوشتن در کاربرگ’ برای صادرات نتایج به کاربرگ جدید. کاربرگ جدید به شکل زیر خواهد بود:
مرحله 3: نتایج را تجزیه و تحلیل کنید
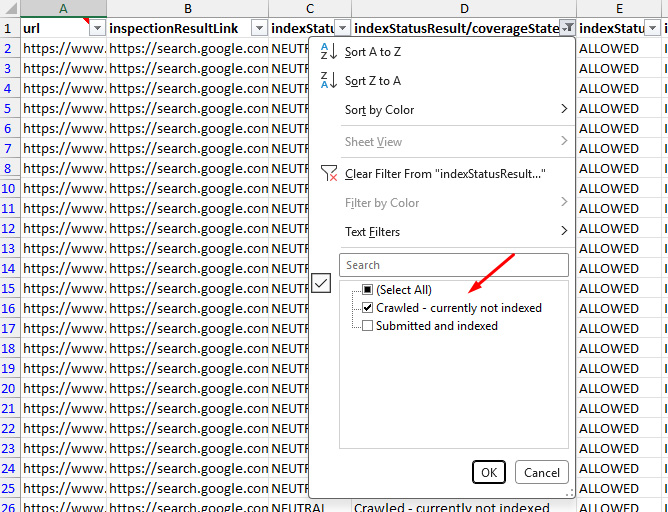
وقتی کارتان تمام شد، وضعیت نمایه سازی را برای هر پی دی اف که تا به حال ایندکس شده است خواهید داشت. شما به راحتی می توانید بر اساس دلایلی مانند Crawled، Not Indexed، Indexed و غیره فیلتر کنید. این فرآیند لیستی از فایل های PDF مهمی را به شما می دهد که زمانی طبقه بندی شده بودند اما اکنون طبقه بندی نشده اند. و در صورت تمایل می توانید برنامه ای برای استفاده مجدد از این فایل های PDF در صفحات html ایجاد کنید. اکنون چندین مشتری دارم که این کار را انجام می دهند.
پاداش: فراتر از حد مجاز 2K URL در روز بروید.
اگر میخواهید این کار را در ویژگیهای مختلف GSC بهطور خودکار انجام دهید (بنابراین میتوانید از محدودیت 2K url در روز فراتر برید)، آموزش من در مورد ایجاد یک سیستم نظارت بر نمایهسازی چند سایتی را دنبال کنید. سپس میتوانید آدرسهای اینترنتی را از تمام ویژگیهای GSC دانلود کنید و وضعیت نمایهسازی آنها را در یک لحظه بررسی کنید.
شکار پی دی اف مبارک.
جی جی