معرفی الگوریتم رتبه بندی مجدد دژان

با افزایش ویژگیهای کمیاب، طبقهبندی مجدد جستجو را بهبود بخشید
در بازیابی اطلاعات، رتبه بندی نتایج جستجو یک کار حیاتی است. روش های سنتی اغلب ویژگی های مشترک را اولویت بندی می کنند که می تواند به نتایج مشترک منجر شود. یک رویکرد جدید برای پرداختن به این شامل تقویت ویژگیهای پراکنده در فضای جاسازی برای بهبود رتبهبندی مجدد است. این روش بر منحصر به فرد بودن و مرتبط بودن تأکید می کند، به ویژه در مجموعه داده های بزرگ که ویژگی های مشترک می توانند غالب باشند.
چگونه کار می کند
هنگامی که یک کاربر درخواستی را ارسال می کند، سیستم یک جاسازی ایجاد می کند – یک نمایش دیجیتالی از معنای درخواست. به طور مشابه، اسناد یا نتایج در پایگاه داده نیز به عنوان جاسازی نشان داده می شوند. رویکرد استاندارد شباهت بین جاسازی پرس و جو و جاسازی سند را محاسبه می کند و نتایج را بر اساس آن شباهت رتبه بندی می کند.
با این حال، این روش مرسوم تمایل دارد ویژگی هایی را که در بسیاری از اسناد مشترک است، ترجیح دهد. در حالی که این ممکن است نتایج بسیار مرتبطی را به همراه داشته باشد، اما خطر نادیده گرفتن اسنادی با ویژگیهای نادر اما بالقوه مهمتر را به همراه دارد.
نقش توابع پراکنده
ویژگیهای پراکنده آن دسته از عناصر در جاسازی هستند که به ندرت در مجموعه داده رخ میدهند. آنها می توانند موضوعات خاص یا ترکیبی منحصر به فرد از ایده ها را نشان دهند. با تقویت این ویژگیهای نادر، الگوریتم رتبهبندی مجدد میتواند وزن بیشتری به اسنادی بدهد که با این روشهای کمتر رایج اما خاصتر مطابقت دارند.
این فرآیند تقویت شامل مراحل زیر است:
جاسازی را ایجاد کنید
پرس و جو و اسناد با استفاده از یک مدل از پیش آموزش دیده به جاسازی تبدیل می شوند.
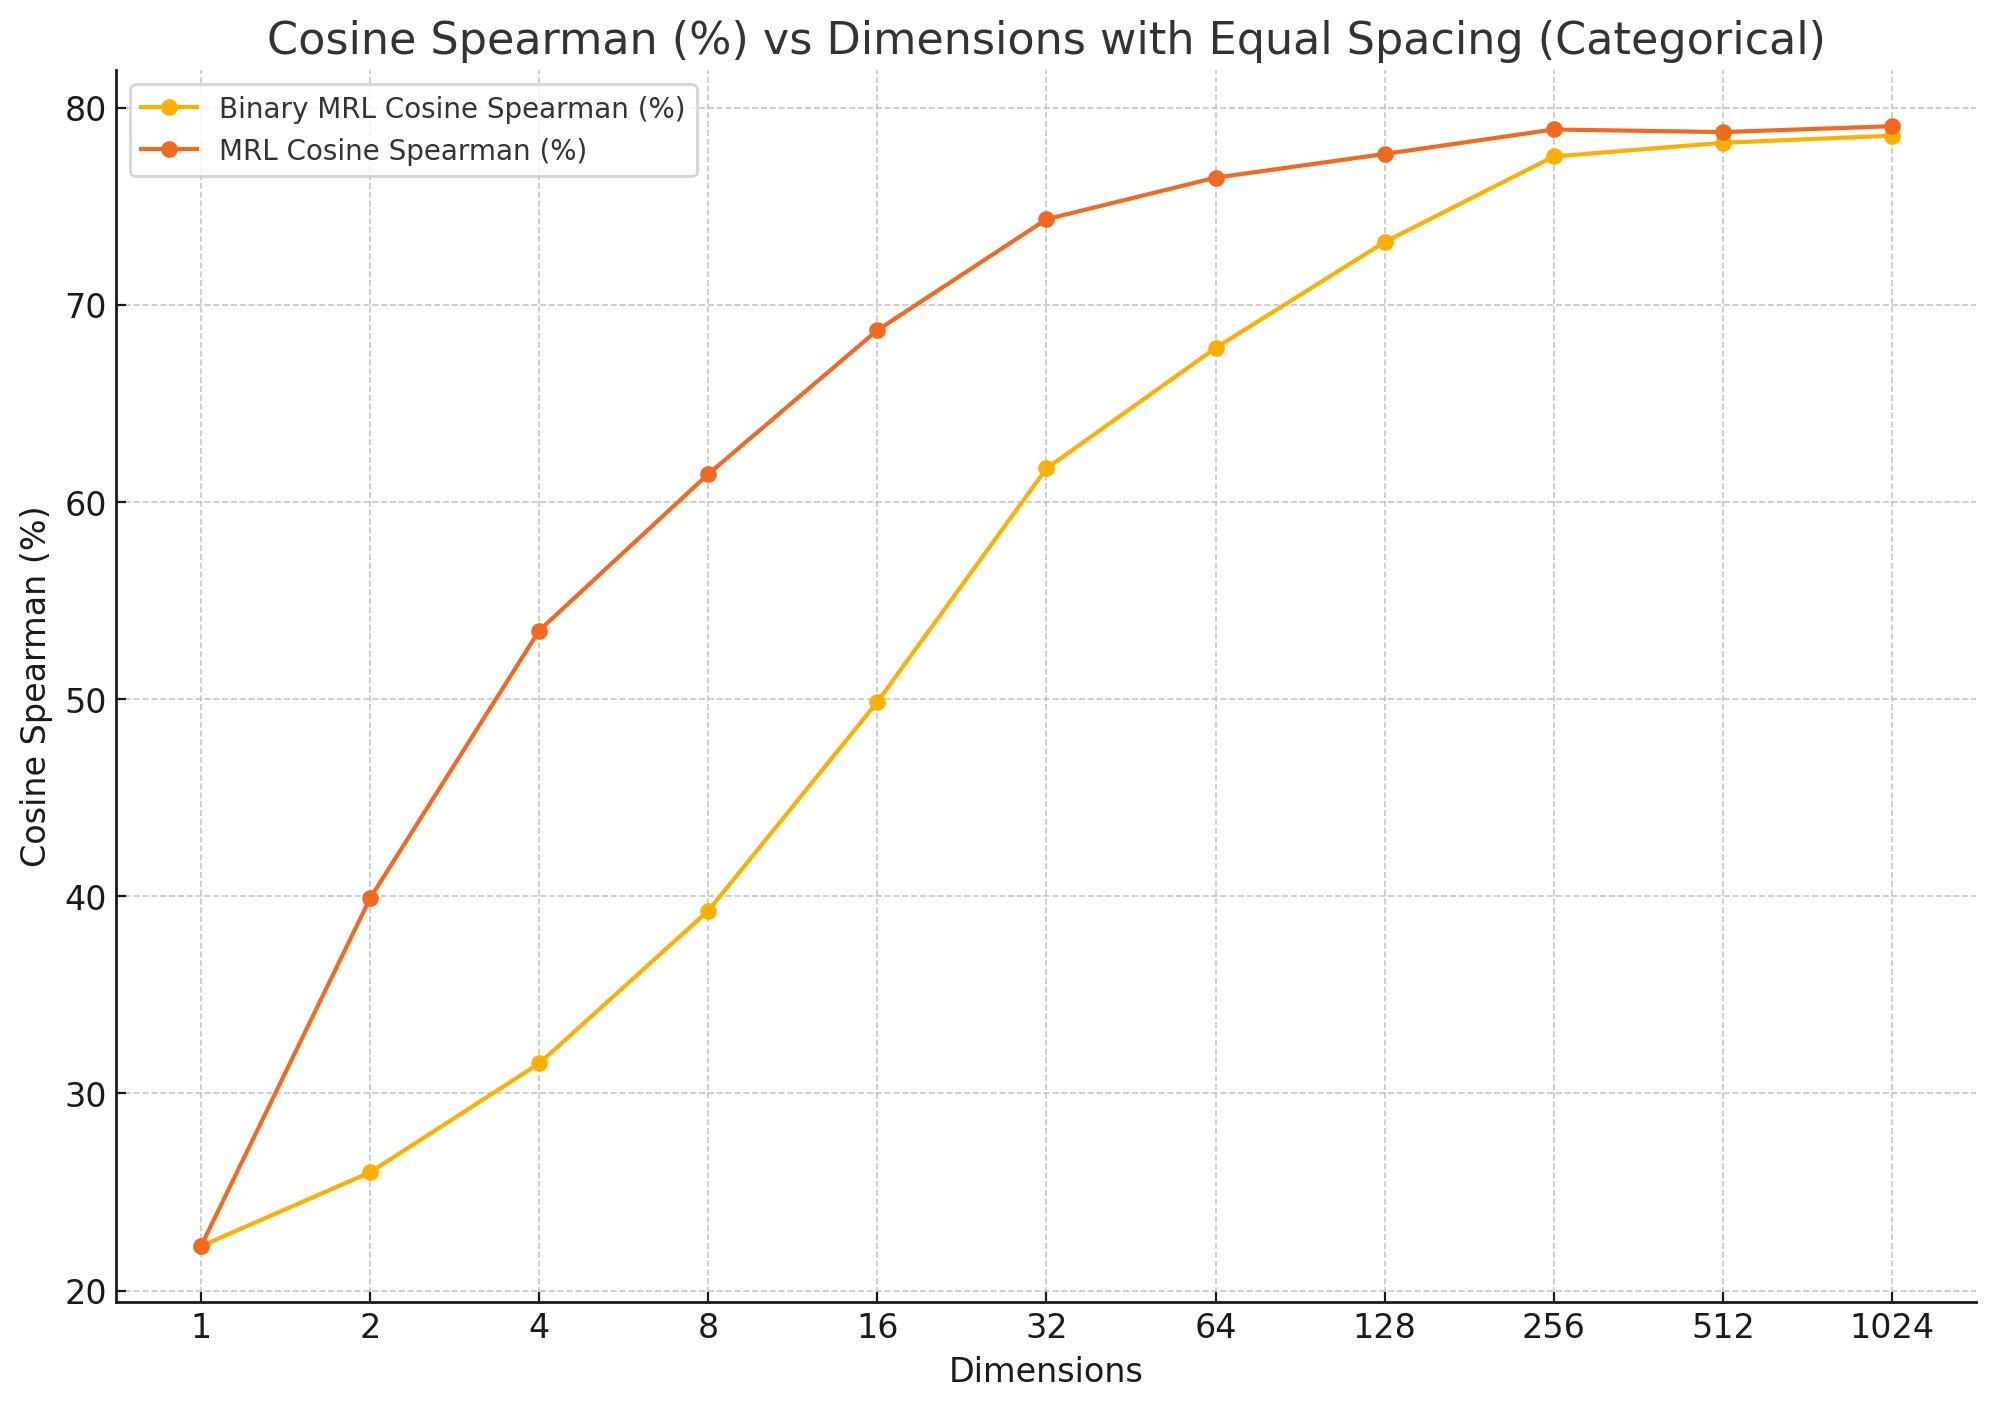
کوانتیزاسیون باینری و برش MRL
از این تکنیکها برای فشردهسازی جاسازیها استفاده میشود و در عین حفظ اطلاعات ضروری، فرآیند کارآمدتر میشود.

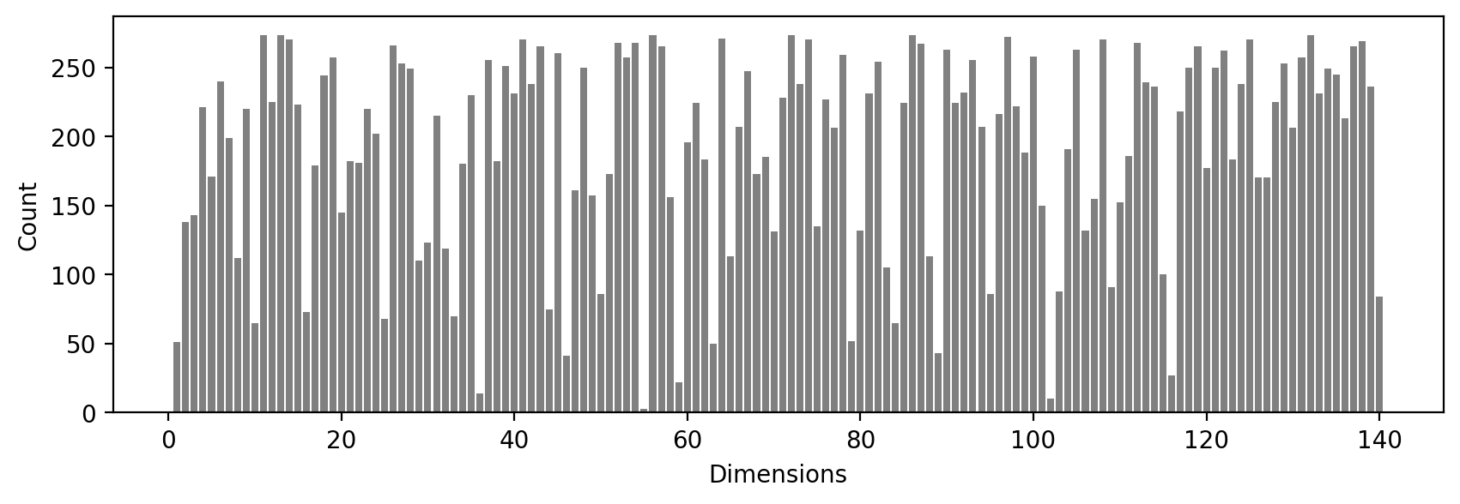
محاسبه فرکانس ویژگی ها
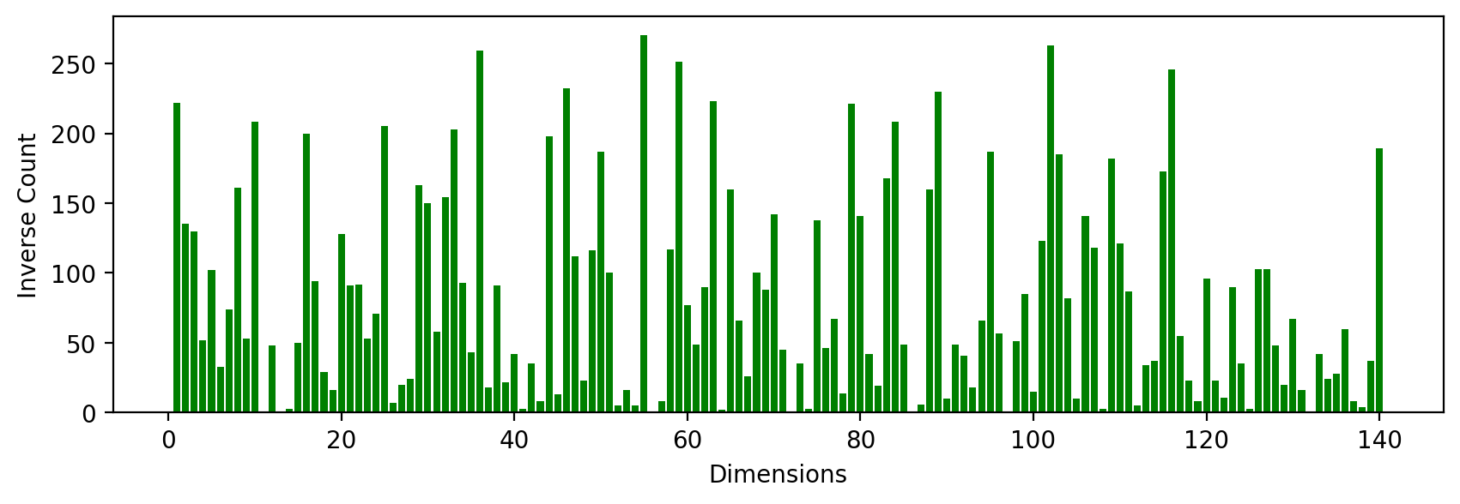
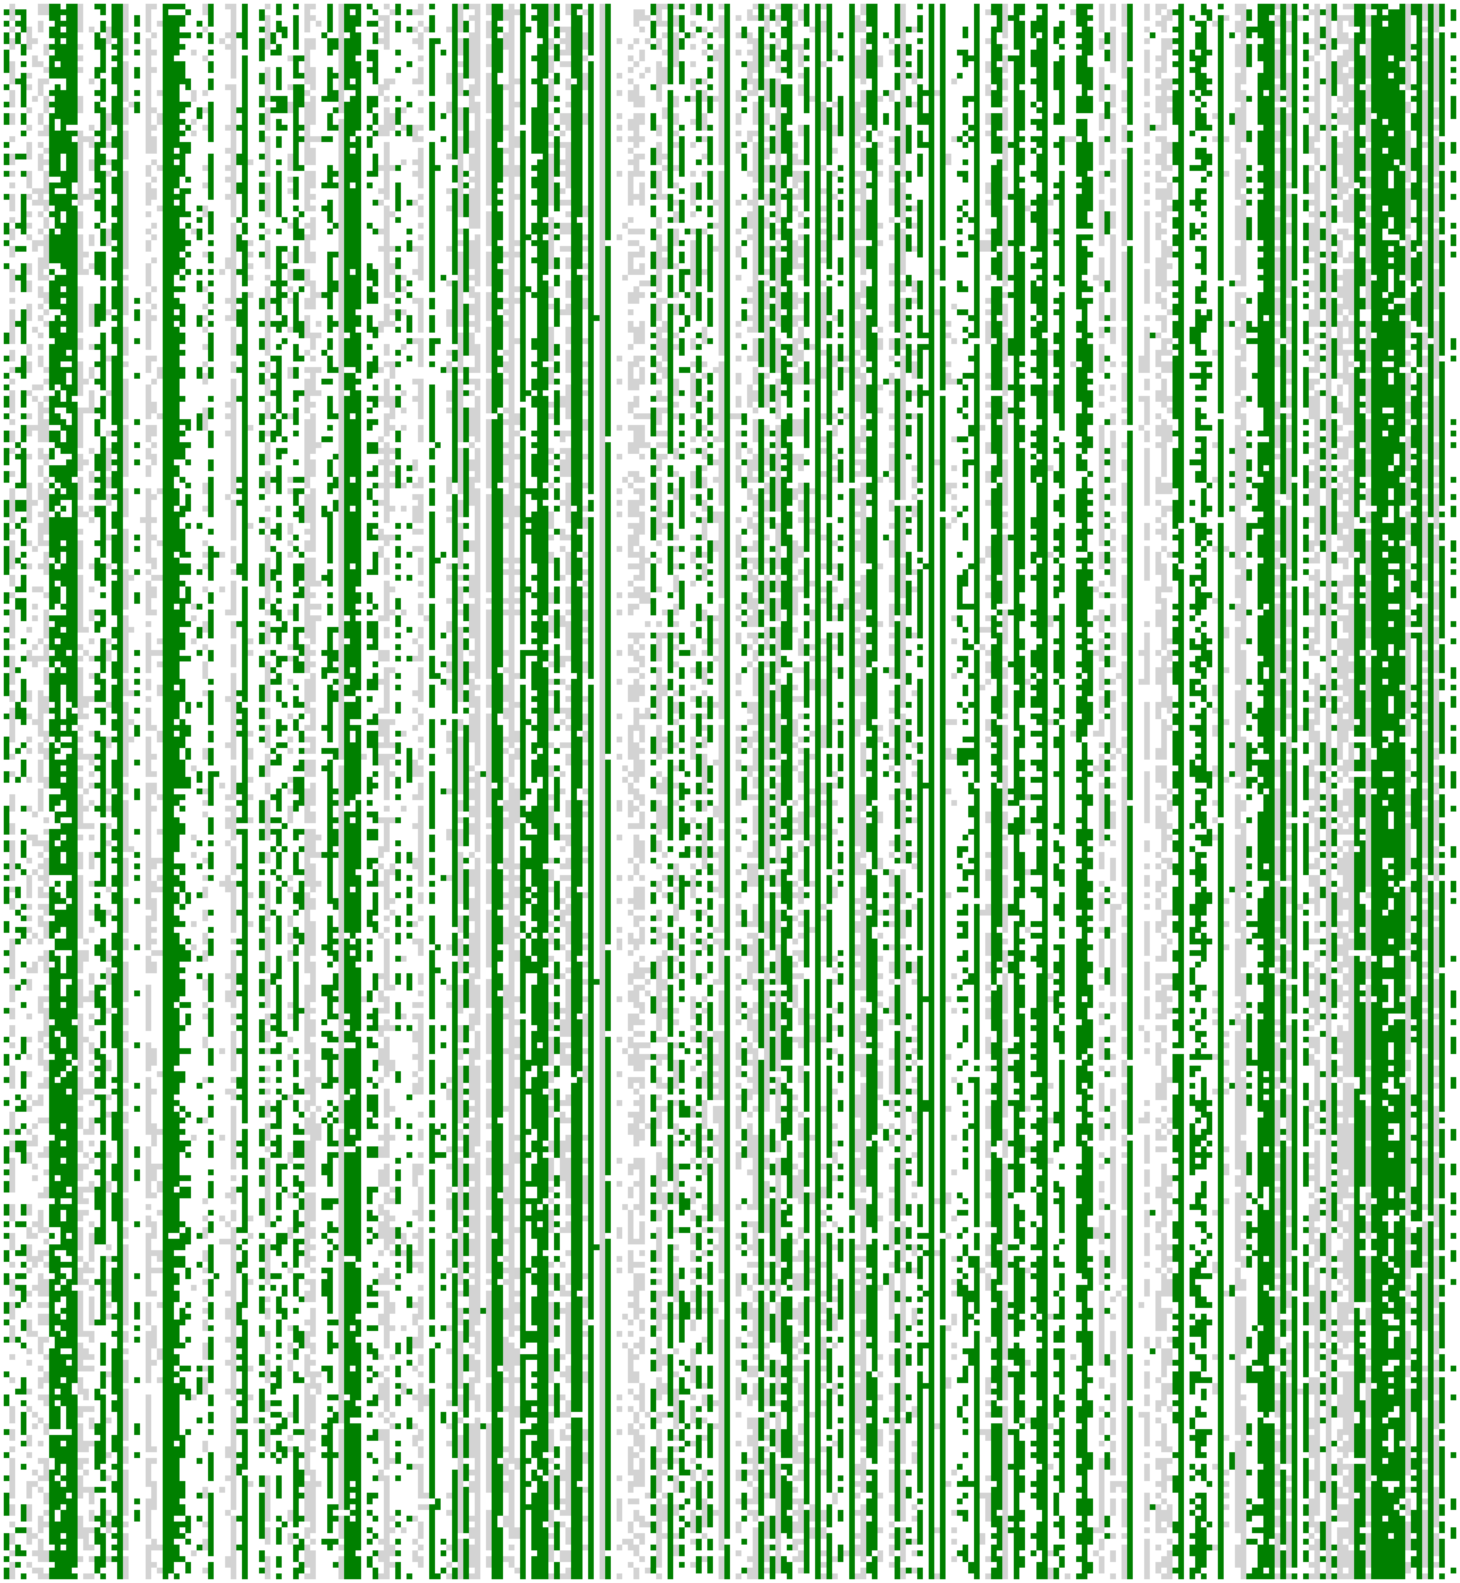
فراوانی هر ویژگی در همه جاسازیهای سند محاسبه میشود. ویژگی هایی که کمتر رخ می دهند به عنوان نادر شناخته می شوند.
زوم دو طرفه
ساختمان ها با افزایش اهمیت ویژگی های کمیاب ثابت می شوند. این کار با استفاده از ضریب مقیاس انجام می شود که وزن این ویژگی ها را در محاسبه شباهت افزایش می دهد. این تکنیک با ترویج ویژگیهای کمیاب، تعبیهها را تصحیح میکند، تأثیر آنها را بر امتیاز شباهت نهایی افزایش میدهد، در حالی که به طور ضمنی تأثیر ویژگیهای رایجتر را کاهش میدهد.
طبقه بندی مجدد
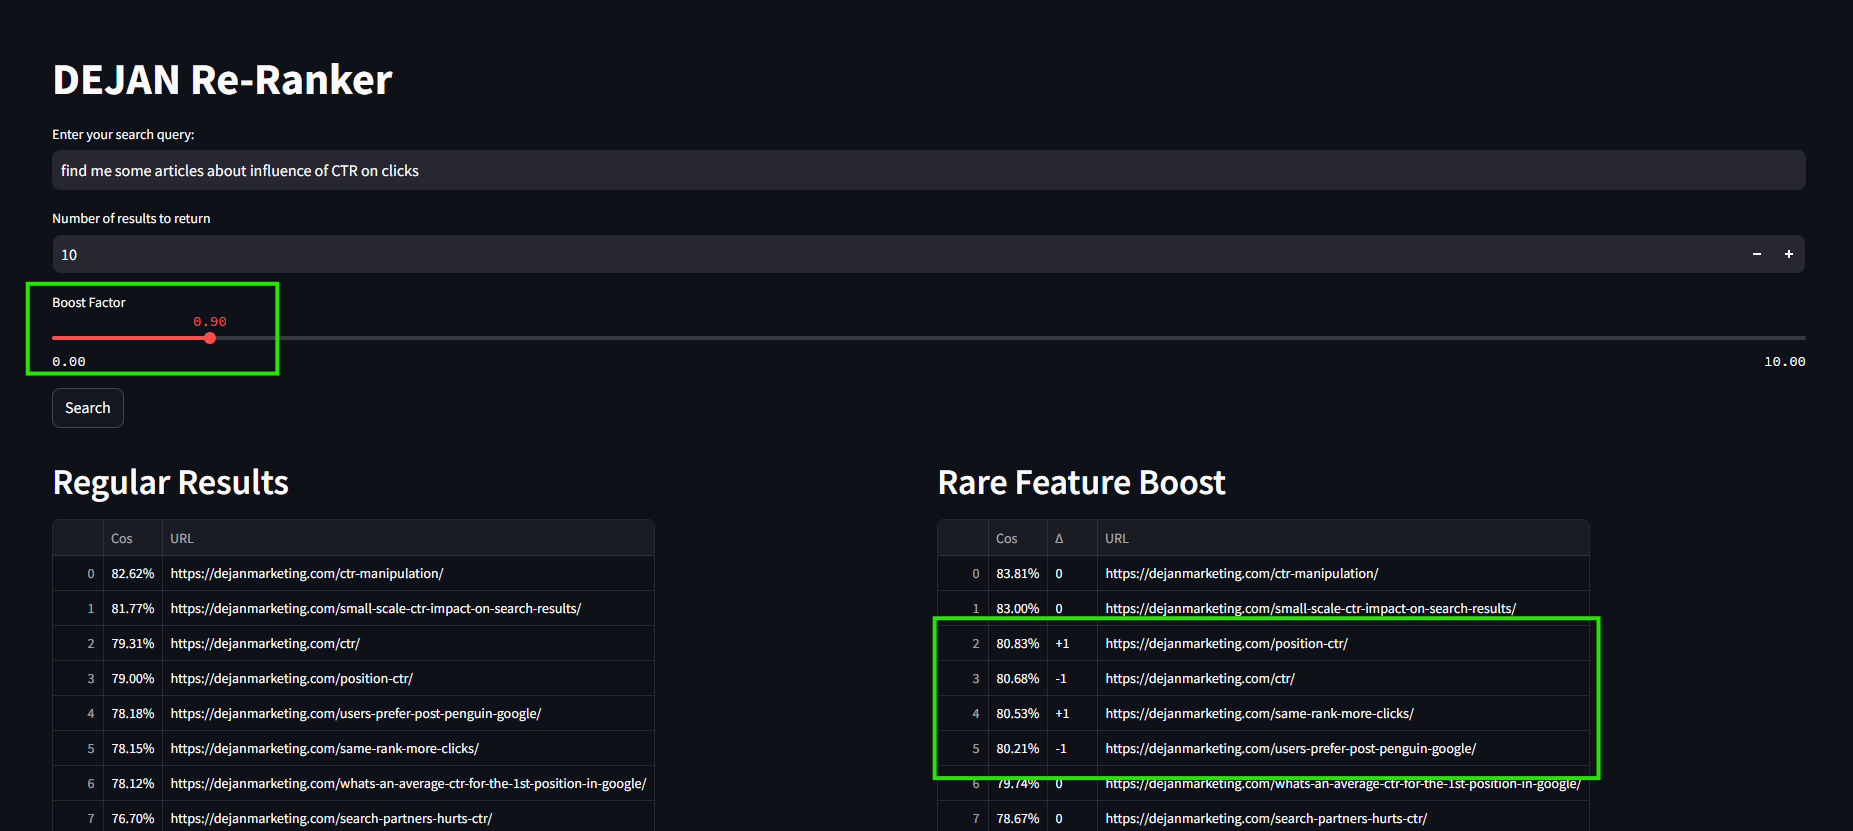
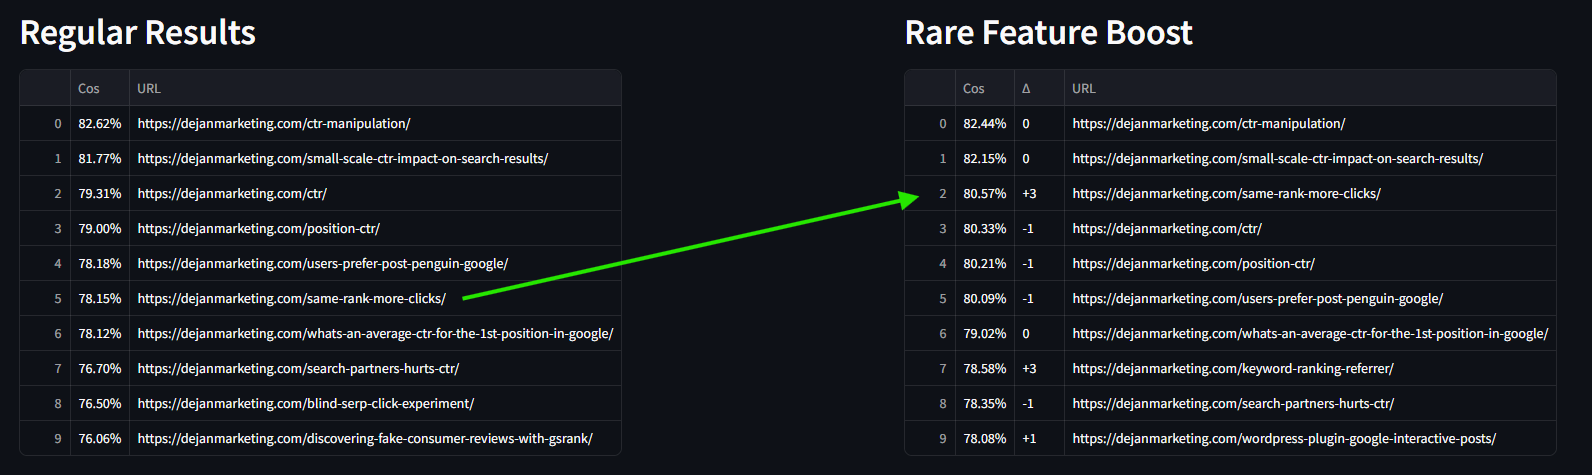
اسناد بر اساس نمرات تشابه تنظیم شده مجدداً رتبهبندی میشوند، که اکنون اسنادی با حضور بیشتر ویژگیهای نادر مطابق با پرس و جو اولویتبندی میکنند.
تجسم و تحلیل
ابزارهایی مانند تجسم تغییر رتبه و نمودارهای فرکانس ویژگی به درک اینکه چگونه رتبهبندی مجدد بر نتایج تأثیر میگذارد کمک میکند و فرآیند مقیاسبندی را اصلاح میکند.
نتایج و فواید
با استفاده از این تکنیک، موتورهای جستجو می توانند نتایجی را که نه تنها مرتبط، بلکه منحصر به فرد و روشنگر هستند، برگردانند. این امر به ویژه در زمینههای تخصصی که ویژگیهای خاص و غیرعادی مهمتر از اهمیت عمومی هستند، ارزشمند است.
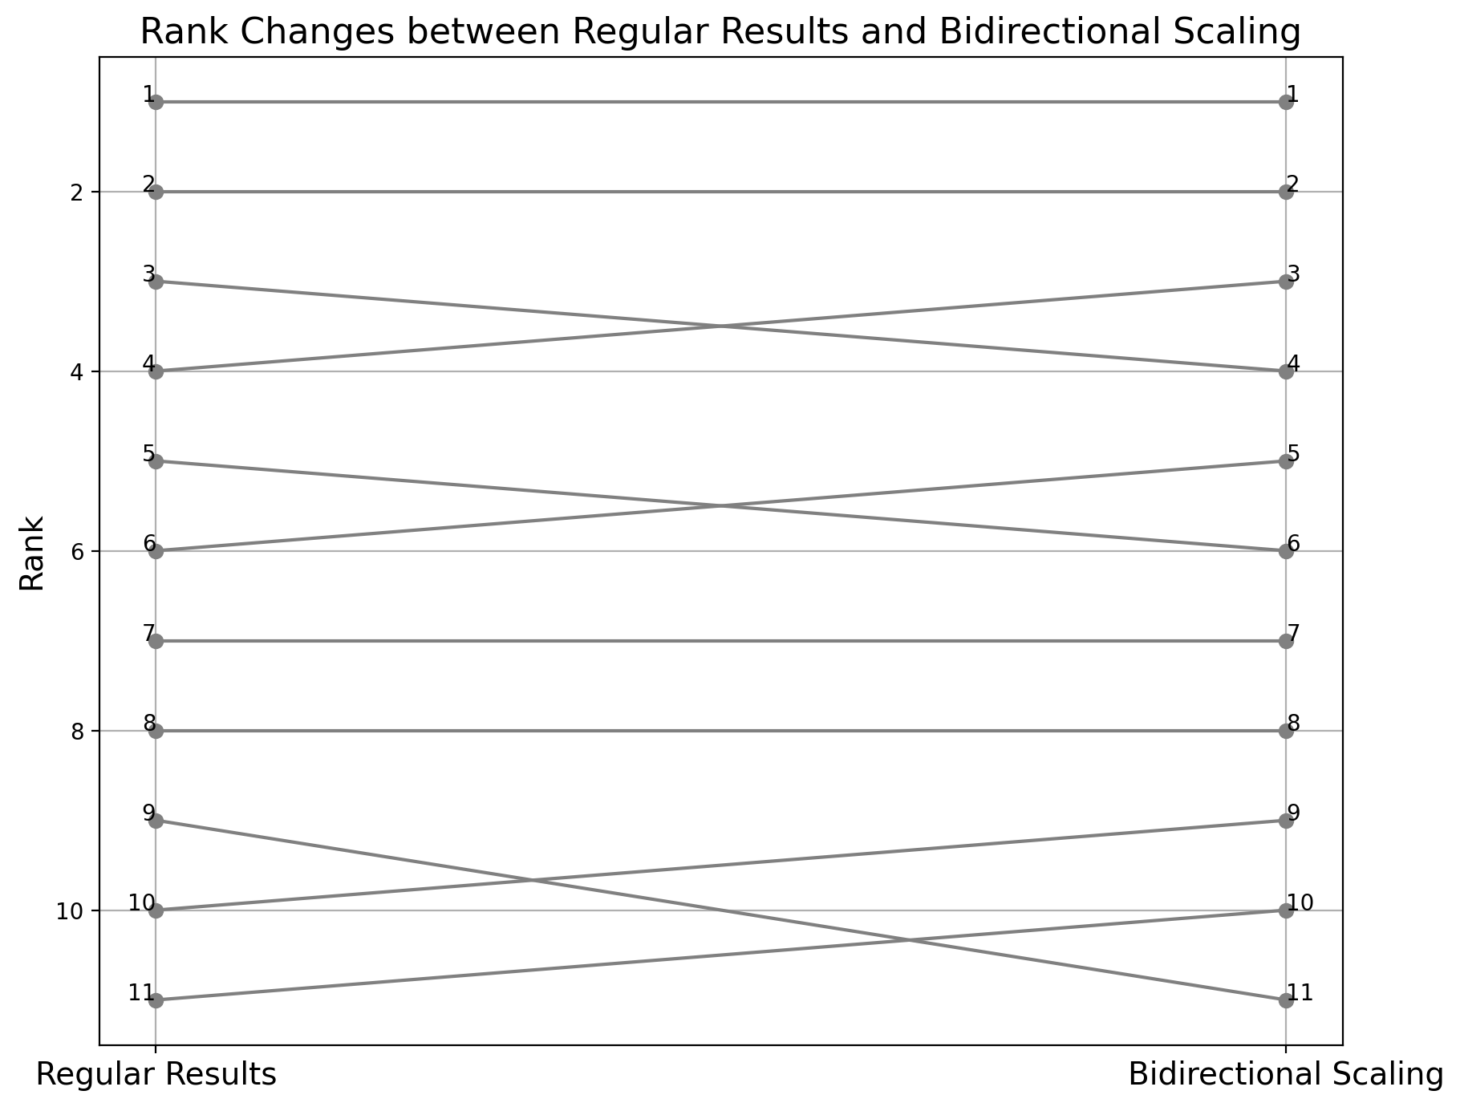
افزایش ویژگی های نادر در فرآیند طبقه بندی مجدد یک روش قدرتمند برای بهبود کیفیت نتایج جستجو است. محدودیتهای الگوریتمهای رتبهبندی سنتی را با اطمینان از اینکه محتوای منحصر به فرد و مرتبط بیشتر در بالای نتایج جستجو ظاهر میشود، برطرف میکند.
اسناد: